 ModelFold
claude-fable-5
Claude Fable 5 是 Anthropic 的 Mythos 级通用模型,面向长时间运行的编程、复杂知识工作、视觉推理,以及需要更强规划与校验能力的多步任务。
定价: 输入 1000 积分 / 百万 token(≈ $5.00),输出 5000 积分 / 百万 token(≈ $25.00)。
今天想聊点什么?
Anthropic 的更多模型
Claude Fable 5 API:Mythos 级的推理、编程与视觉能力
通过 ModelFold 调用 Claude Fable 5 API,处理复杂编程项目、自主智能体、多模态推理和文档密集型工作流。
Claude Fable 5 是什么?和 Claude Mythos 是什么关系?
Claude Fable 5 于 2026 年 6 月 9 日发布,是 Anthropic 面向通用场景的 Mythos 级模型,在长时间运行的编程项目、复杂知识工作、视觉推理、科学研究和多步自主任务上能力更强。它专为需要在长上下文中持续推理的负载而设计,包括软件工程、文档密集型分析、技术研究,以及需要模型自己规划、校验并打磨输出的智能体工作流。 Claude Fable 5 和 Claude Mythos 5 在模型层面同属一类,但面向的使用场景不同。Anthropic 将 Fable 5 描述为「可安全通用的 Mythos 级模型」,而 Mythos 5 仅在受限的可信访问场景中提供,并放开了部分安全限制。对于构建生产工作流的开发者,ModelFold 提供 Claude Fable 5 API,用于高级推理、编程、视觉和企业知识类应用。
Claude Fable 5 API 核心功能
长时间任务中的持续推理
Claude Fable 5 能在漫长的多阶段工作中保持连贯,持续跟踪目标、约束、中间发现和修改步骤。当任务需要连续性、周密规划和反复校验才能交付最终结果时,这一点尤为重要——它不会把每次回复当成孤立的任务。
高级代码理解与高质量实现
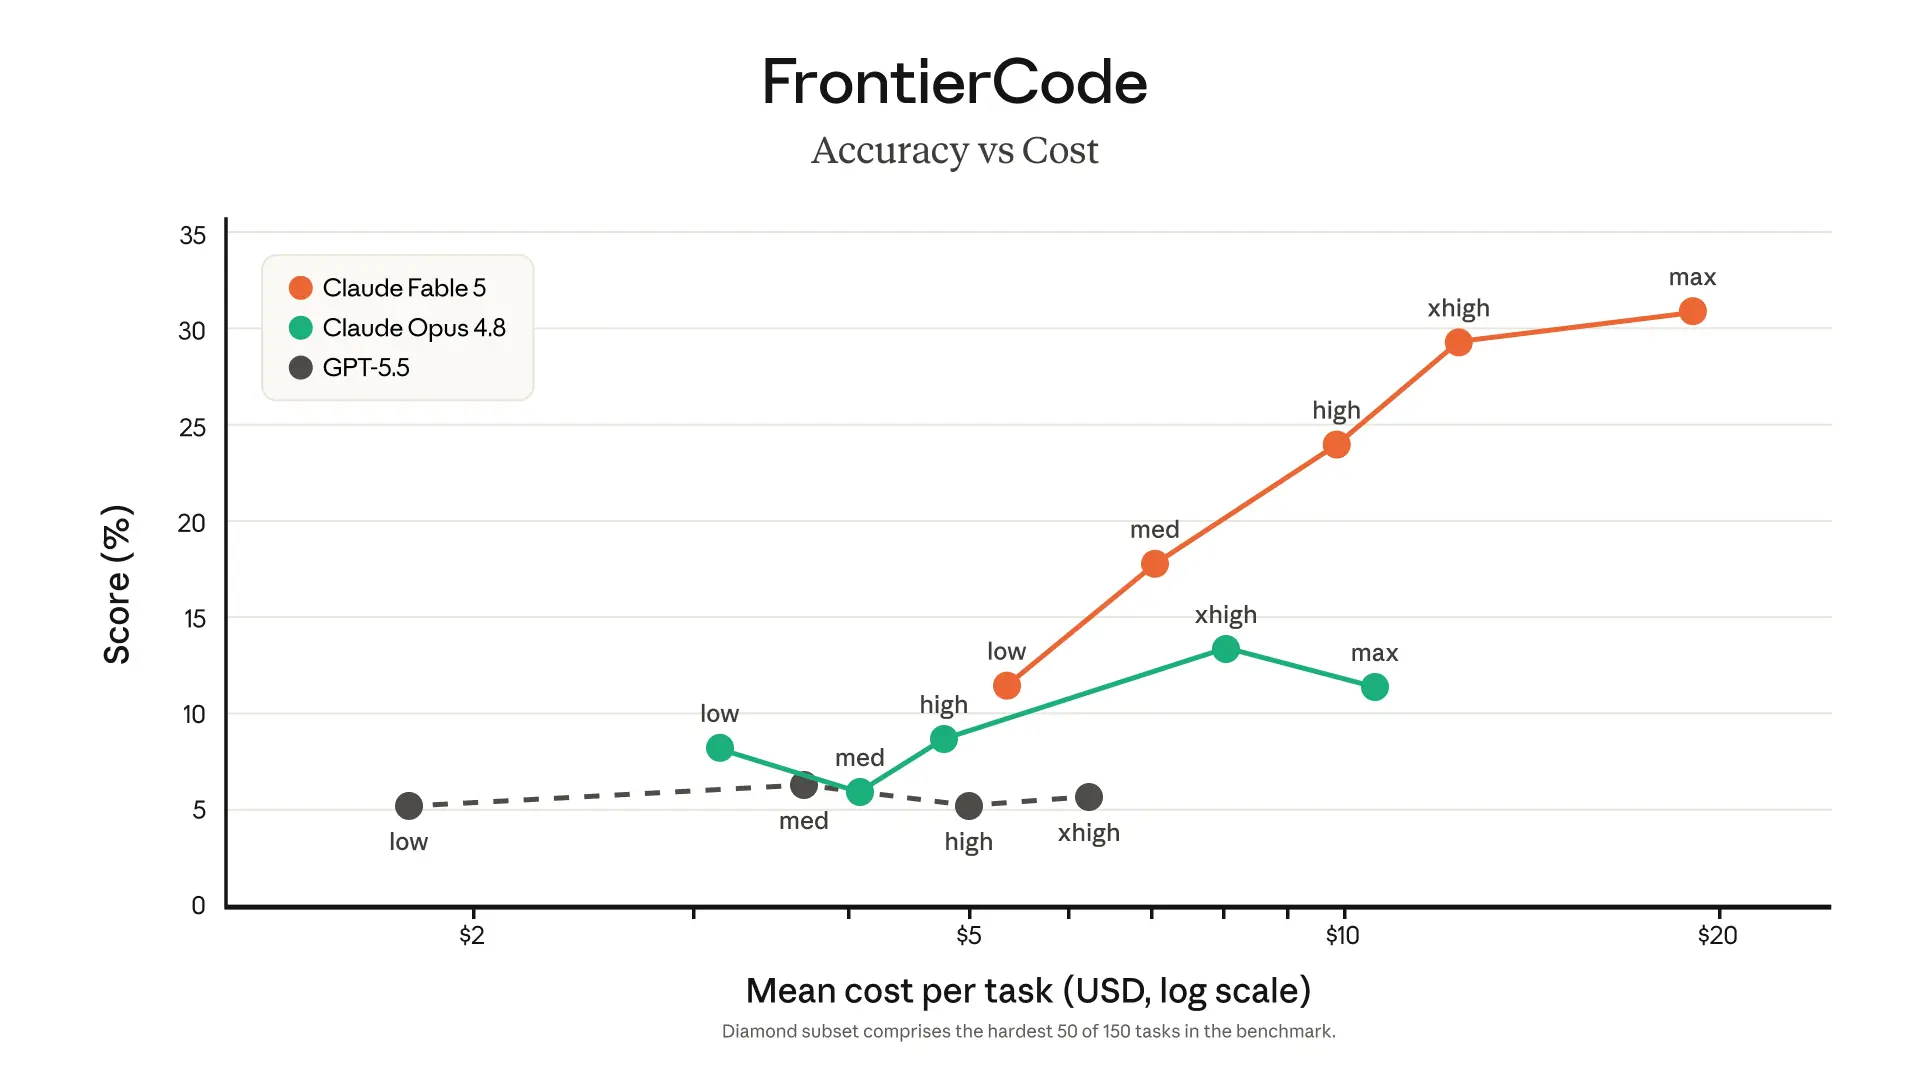
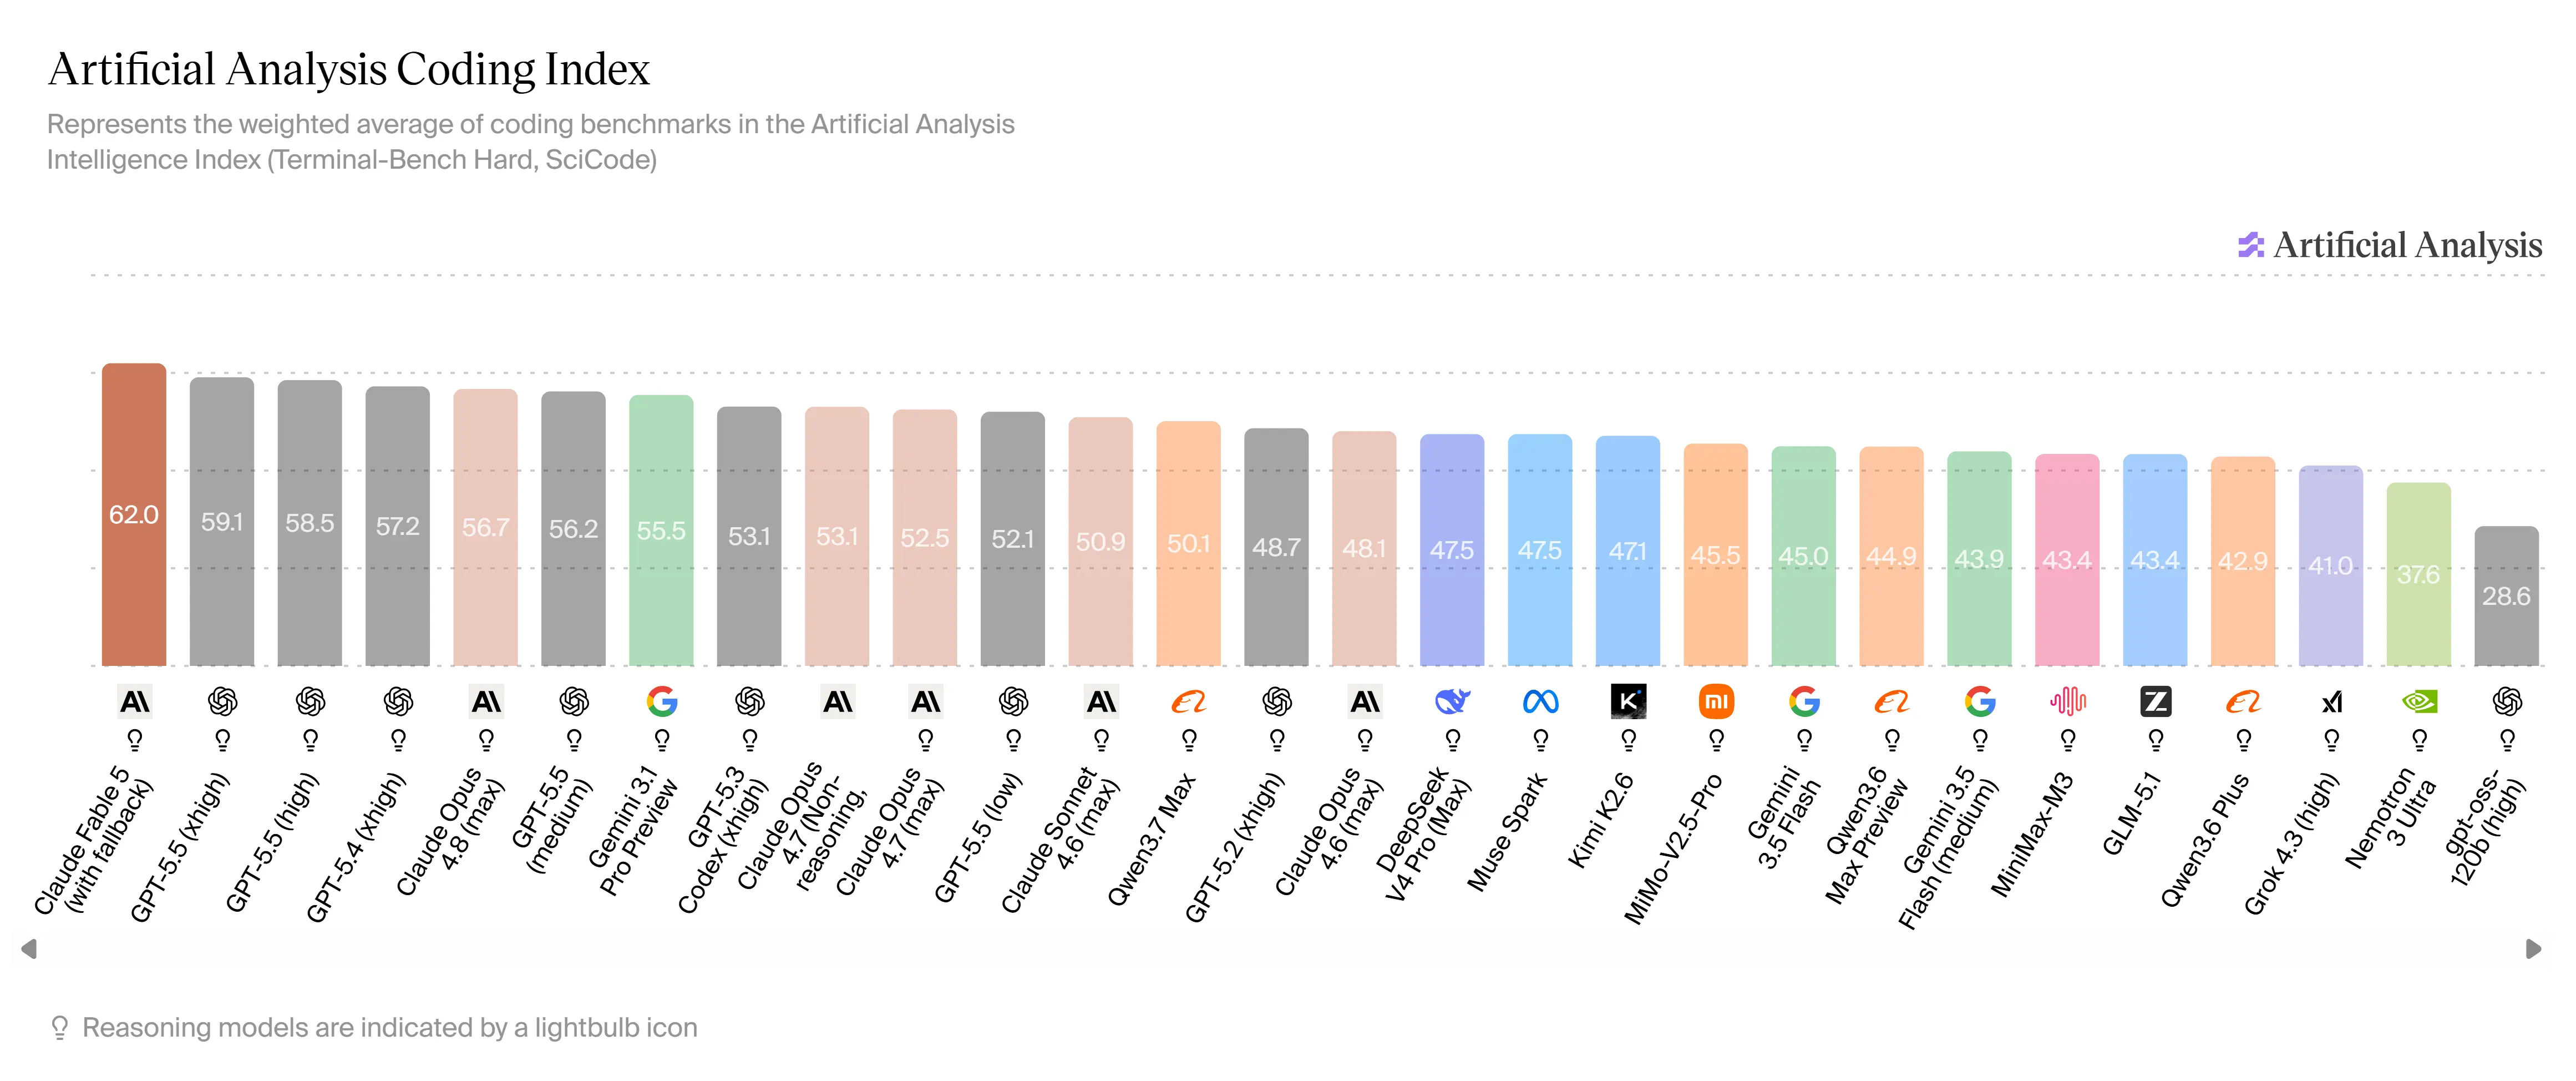
在高要求的软件工程场景中,Claude Fable 5 可支撑大规模迁移、复杂功能实现、调试、重构和测试生成。它的编程优势不只在于写代码,还在于理解整个项目上下文、梳理依赖关系、检查实现行为,并借助测试或视觉反馈提升结果的可靠性。
100 万 token 的大上下文知识推理
借助 100 万 token 上下文窗口,Claude Fable 5 能处理大得多的输入,同时保留更多周边上下文。当任务依赖长文件、大量研究资料、代码仓库上下文、多文档分析或难以压缩进短提示词的详细指令时,这一能力尤其有用。
面向技术资料和文档的视觉理解
除了文本推理,Claude Fable 5 还能理解图示、图表、表格、截图、科研图片以及文件或 PDF 中的视觉内容。当答案取决于版式、视觉关系、图表数值、界面状态,或难以用纯文本表达的信息时,它能给出更有依据的判断。
安全防护、回退机制与对齐评估
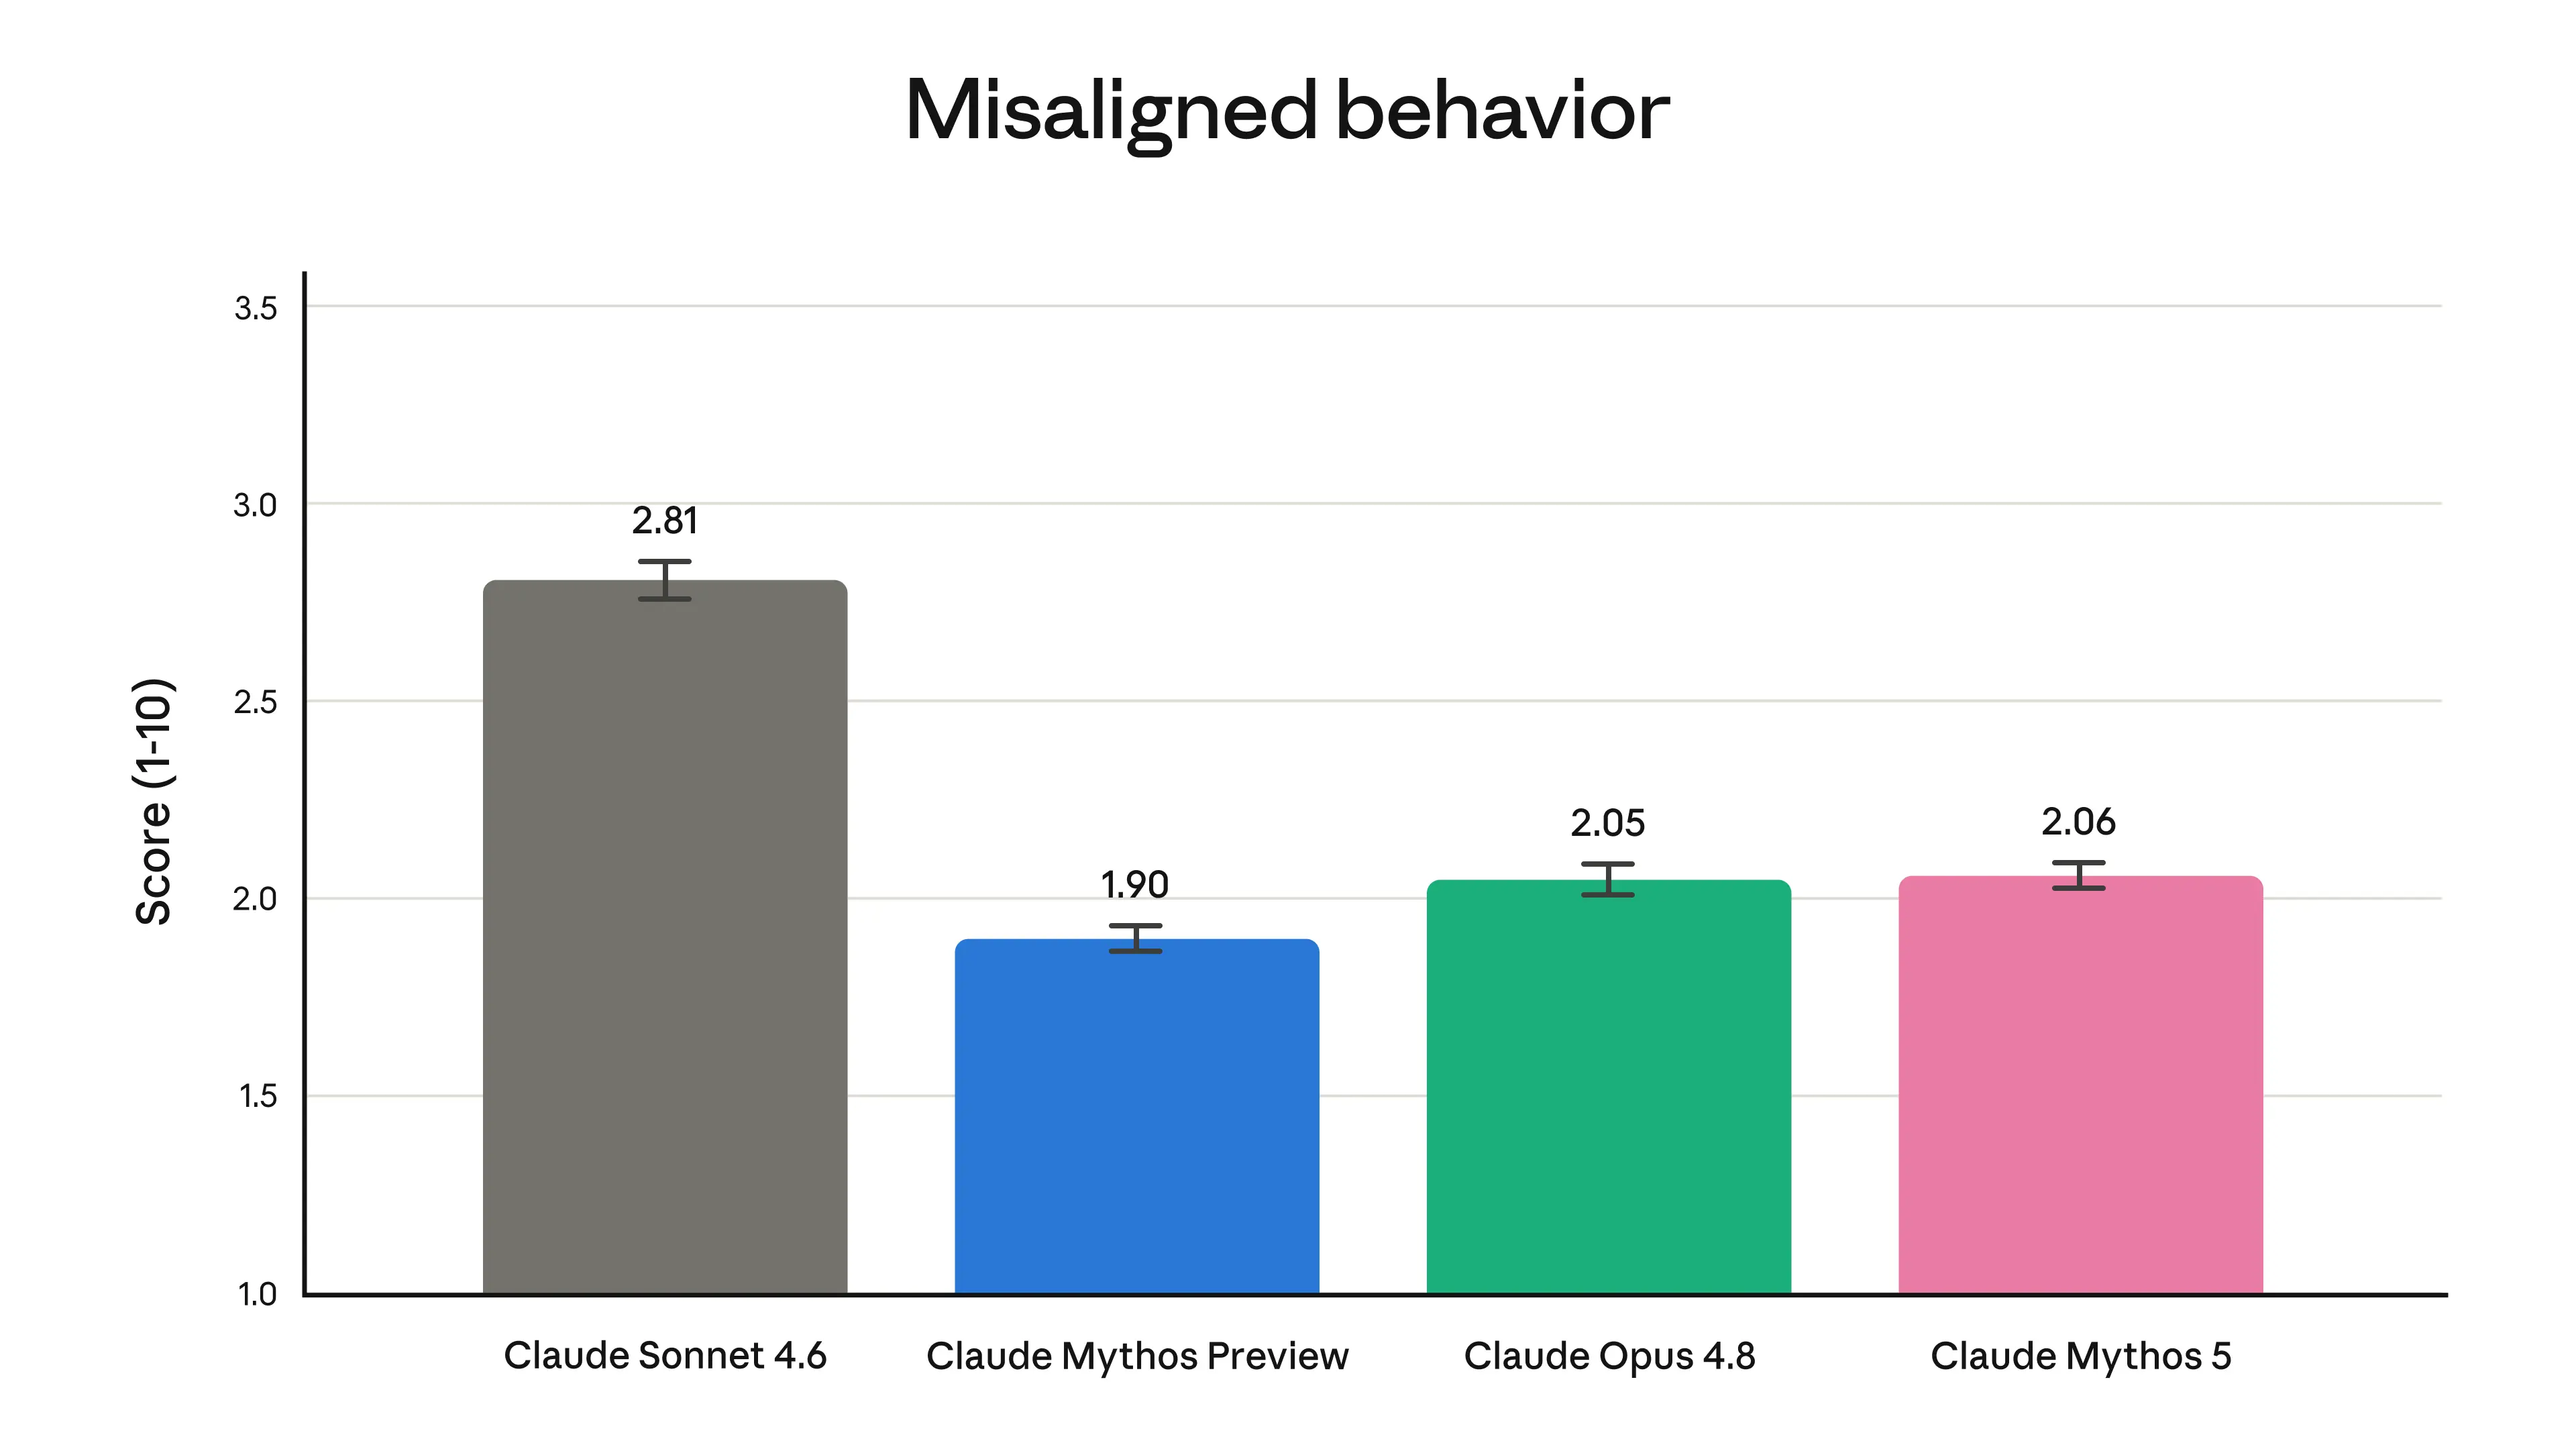
作为面向公众开放的 Mythos 级模型,Claude Fable 5 对敏感能力领域加了额外防护。涉及网络安全、生物和化学或模型蒸馏的请求,可能会被转交给 Claude Opus 4.8 等回退模型处理。相关对齐评估显示 Mythos 5 的失准行为很低,由于两者基于同一底层模型,Fable 5 预计表现相近。
Claude Fable 5 与主流模型的基准对比
Claude Fable 5 在智能体编程、知识工作、视觉推理、空间推理、工具调用、电脑操作、法律评测、跨学科推理、生物、网络安全和健康等任务上,相比其他主流模型都有很强的成绩。对于评估 Claude Fable 5 API 的开发者,这些结果最适合作为复杂编程、长上下文推理、视觉分析、智能体工作流和高级知识工作的能力参考。下表基于官方的 Claude Mythos 5 / Fable 5 基准表,两者的成绩通常相差 1–3 个百分点,表中取较高值。带星号的项目需格外谨慎:网络安全和生物类问题的防护可能触发回退,从而影响 Claude Fable 5 的结果。
| 评测领域 | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|
| 智能体编程 SWE-Bench Pro | 80.30% | 77.80% | 69.20% | 58.60% | 54.20% |
| 智能体编程 FrontierCode Diamond | 29.30% | — | 13.40% | 5.70% | — |
| 知识工作 GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| 知识工作(视觉) GDP.pdf | 29.80% | — | 22.50% | 24.90% | 16.70% |
| 空间推理 Blueprint-Bench 2 | 38.60% | — | 14.50% | 36.20% | 26.50% |
| 工具调用 AutomationBench | 17.40% | — | 15.50% | 12.90% | 9.60% |
| 电脑操作 OSWorld-Verified | 85.00% | 85.40% | 83.40% | 78.70% | 76.20% |
| 法律 Legal Agent Benchmark | 13.30% | — | 10.40% | 2.10% | 0.00% |
| 跨学科推理 Humanity’s Last Exam(不用工具) | 59.0%* | 56.80% | 49.80% | 41.40% | 44.40% |
| 跨学科推理 Humanity’s Last Exam(使用工具) | 64.5%* | 64.70% | 57.90% | 52.20% | 51.40% |
| 生物 BioMysteryBench(困难) | 46.1%* | 29.60% | 40.00% | — | — |
| 生物 BioMysteryBench(人类已解) | 83.9%* | 82.60% | 80.40% | — | — |
| 智能体编程 Terminal-Bench 2.1 | 88.0%* | — | 82.70% | 83.40% | 70.70% |
| 网络安全 ExploitBench(Cap%) | 78.0%* | 69.00% | 40.00% | 34.00% | — |
| 健康 HealthBench Professional | 66.0%* | 64.70% | 56.90% | 51.80% | — |
在 ModelFold 上开始使用 Claude Fable 5 API
只需几个简单步骤即可上手。
- 1
第 1 步:获取 API Key
注册或登录 ModelFold,在控制台创建 API Key,用它为你的应用、后端服务、智能体框架或开发环境中的请求做鉴权。搭建完整流程前,先查阅最新的接口文档,确认端点格式、模型名、请求参数、输入限制和支持的返回设置。
- 2
第 2 步:用真实任务测试
测试时用有代表性的提示词,而不是简单的问候。Claude Fable 5 是为复杂工作设计的,第一轮评估应包括多步编程指令、长文档分析、图表或截图解读、结构化研究综述、智能体式规划等任务。测试中重点对比输出质量、推理深度、格式稳定性、敏感类别下的回退行为,以及模型能否在长输入中保持任务上下文。
- ✓
第 3 步:接入生产工作流
测试完成后,把 Claude Fable 5 接入最能发挥它优势的环节,例如编程智能体、代码仓库分析、企业文档审阅、研究助理、视觉推理工具或内部自动化系统。为任务划清边界、要求结构化输出、做好日志记录,重要决策加入人工审核——尤其是涉及长时间任务、敏感资料或可能影响生产系统的输出时。
Claude Fable 5 API 在复杂 AI 工作流中的位置
代码库迁移项目
Claude Fable 5 能支撑大型代码库迁移:理解现有结构、遵守实现约束、跨依赖推理,并帮助生成迁移方案或代码改动。当项目涉及大量文件、遗留写法、测试更新和反复校验,而不是简单的单文件修改时,它尤其适用。
设计稿到代码的审查
Claude Fable 5 可以帮助检查前端实现是否与截图、设计稿、产品需求或视觉参考一致。它把代码推理和视觉理解结合起来,可用于检查布局一致性、找出 UI 不符之处、解释视觉缺陷,并把设计要求和实现细节对应起来。
财务与商业文档分析
Claude Fable 5 适合处理长篇报告、财务资料、图表、表格、电子表格、商业计划书和内部分析文档的工作流。它能提炼要点、对比证据、梳理假设,为分析师、运营人员或决策团队整理结构化摘要和审阅意见。
法律与政策审阅
Claude Fable 5 可以协助完成合同、政策文件、合规材料、内部规范和法律研究笔记等文档密集型审阅任务:对比条款、找出重要义务、总结风险,把晦涩的材料整理成更清晰的审阅草稿,最终判断仍交由专业人士。
研究综述与技术报告撰写
Claude Fable 5 能支撑需要通读论文、技术文件、实验记录、图表和长篇参考资料的研究工作:整理发现、对比方法、解释技术证据,为科研、工程、产品或战略团队准备结构化的报告草稿。
内部智能体工作流
Claude Fable 5 可作为内部智能体的推理核心,负责规划任务、执行多步指令、协调子任务、检查中间产出并准备最终交付物。这让它适合编程助手、研究智能体、运营副驾、文档审阅智能体,以及需要比普通聊天机器人更强连贯性的内部效率工具。
为什么用 ModelFold 接入 Claude Fable 5 API
一个平台接入多家模型
ModelFold 在多模型平台中提供 Claude Fable 5 API,开发者无需为每家服务商单独搭建流程,就能评估各种高级推理模型。当产品在编程、文档分析、视觉推理、智能体流程或结构化企业任务上需要不同模型时,ModelFold 能帮团队把 Claude Fable 5 和其他模型放在一起比较,找到它最适合的位置。
清晰的接口文档,集成更快
ModelFold 上的 Claude Fable 5 API 文档帮助开发者在实现前确认最新的端点格式、模型名、请求参数、鉴权方式、输入要求和返回设置。对于涉及长上下文、图片或文件、结构化输出和智能体式指令的复杂流程,清晰的文档能减少集成阻力,让团队更快从测试走到应用开发。
灵活定价,按积分测试
ModelFold 支持用积分测试 Claude Fable 5 API,开发者可以先用真实提示词评估,再决定是否扩大用量。我们不会把 Claude Fable 5 宣传成完全免费或无限量,而是让你用现有积分方便地测试编程任务、文档输入、视觉推理、长指令和智能体式提示词,再判断它是否符合项目的成本和性能预期。
7×24 小时开发支持
ModelFold 为使用 Claude Fable 5 API 的开发者提供 7×24 小时支持,涵盖接入、文档、积分、测试和集成配置等问题。对于高级 AI 工作流,问题往往涉及长上下文行为、视觉输入、结构化返回格式、回退敏感场景或应用层调试,而不只是简单的提示词测试,这时支持尤为有用。
Claude Fable 5 API 常见问题
Claude Fable 5 是什么?⌄
Claude Fable 5 是 Anthropic 面向通用场景的 Mythos 级模型,专为复杂编程、长时间任务、知识工作、视觉推理、科学分析,以及需要比普通聊天模型更强的规划、上下文保持和校验能力的多步工作流而设计。
Claude Fable 5 和 Claude Mythos 是什么关系?⌄
Claude Fable 5 和 Claude Mythos 5 在底层模型上关系密切,但面向不同的访问和安全场景。Claude Fable 5 是面向公众开放、带安全防护的 Mythos 级模型;Claude Mythos 5 仅在受限的可信访问场景中提供,经批准的用途下可能会放开部分防护。
开发者可以用 Claude Fable 5 API 做什么?⌄
可以用来构建编程智能体、代码库分析、文档审阅工具、研究助理、视觉推理流程、企业知识系统和内部自动化产品。当应用需要长上下文推理、多步任务执行、结构化输出,或对文本和视觉输入做更深入的分析时,它最能发挥价值。
Claude Fable 5 擅长编程吗?⌄
擅长。它定位于高要求的软件工程工作,包括大规模迁移、复杂实现、调试、重构、测试生成和仓库级推理。当任务需要更广的项目上下文、依赖推理和校验,而不是一小段代码时,它的价值最明显。
Claude Fable 5 能处理长文档、文件和大型代码库吗?⌄
能。Claude Fable 5 专为长上下文工作设计,支持 100 万 token 上下文窗口,适合长文档、大量研究资料、代码仓库上下文、详细指令和多文档分析。具体实现时,仍请查阅 ModelFold 上最新的接口文档,确认当前的输入限制、支持的格式和请求规则。
Claude Fable 5 能理解图片、图表、表格和 PDF 吗?⌄
能。它可以对截图、图示、图表、表格、科研图片以及文件或 PDF 中的视觉内容进行推理,适用于 UI 审查、设计稿到代码的核对、图表解读、视觉文档分析,以及关键信息藏在版式或图片里的技术工作流。
为什么 Claude Fable 5 会触发回退?⌄
Claude Fable 5 对敏感能力领域设有防护。涉及网络安全、生物和化学或模型蒸馏的请求,可能会被转交给 Claude Opus 4.8 等回退模型。如果你的工作流可能涉及受限、两用或高度敏感的话题,需要了解这一行为。
Claude Fable 5 API 适合生产环境吗?⌄
适合需要高级推理、编程辅助、文档分析和视觉理解的生产应用。用于生产时,建议划清任务边界、校验输出、监控可能触发回退的情况,并在结果可能影响业务、法律、工程或运营决策时加入人工审核。
在哪里查看 Claude Fable 5 API 的价格和文档?⌄
实现前请查看 ModelFold 上最新的价格和接口文档。价格、积分规则、端点格式、模型名、请求参数、支持的输入和使用细节都可能调整,上线前应以 ModelFold 当前文档为准。
| 输入 | 1000 积分 /百万 token≈ $5.00 |
| 输出 | 5000 积分 /百万 token≈ $25.00 |
按 token 计费:输入、输出分别计价,思考过程的 token 按输出计。Playground 与 API 扣费口径完全一致。
查看接口文档 →curl https://ai.modelfold.online/v1/chat/completions \
-H "Authorization: Bearer $MODELFOLD_API_KEY" \
-H "Content-Type: application/json" \
-d '{"model":"claude-fable-5","messages":[{"role":"user","content":"Hello"}]}'