 ModelFold
deepseek-v4-1-flash
DeepSeek-V4.1-Flash 是一款多模态模型,推理更快、吞吐更高,在推理、编程、视觉理解和智能体任务上表现更强,兼顾效率与复杂多步任务所需的能力。
定价: 输入 30 积分 / 百万 token(≈ $0.15),输出 118.75 积分 / 百万 token(≈ $0.59)。
今天想聊点什么?

DeepSeek-V4.1-Flash API:快速高效的多模态推理
用 DeepSeek-V4.1-Flash API 实现快速推理、原生视觉理解、编程和智能体工作流,其架构专为高效推理和高吞吐而设计。
DeepSeek-V4.1-Flash API 核心功能
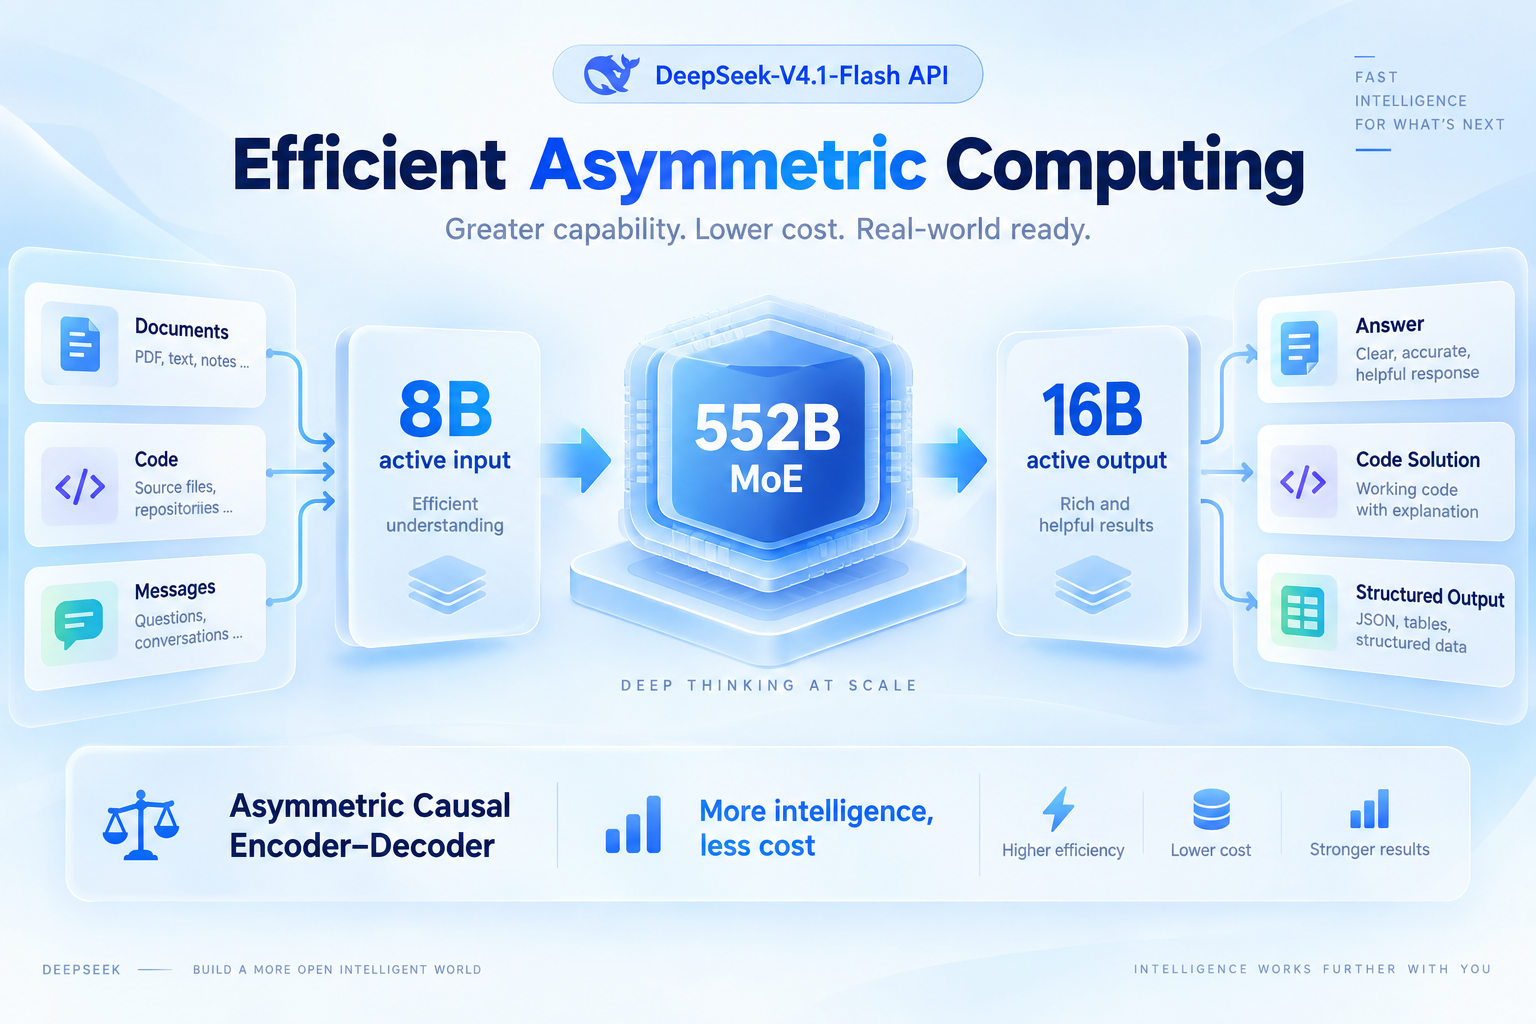
高效的非对称计算
DeepSeek-V4.1-Flash 基于 5520 亿参数的混合专家(MoE)主干,采用全新的因果编码器–解码器架构,对输入和输出进行非对称计算:处理输入时每个 token 约激活 80 亿参数,生成输出时约激活 160 亿参数,相对于总模型容量大幅减少了实际计算量。
原生视觉理解
DeepSeek V4.1 Flash 并不是把视觉当作外挂功能,而是在同一个多模态架构中原生处理图片和文本。从语言模型预训练阶段起,视觉嵌入和文本嵌入就是联合处理的,让模型在文本推理之外天然具备图像理解能力。

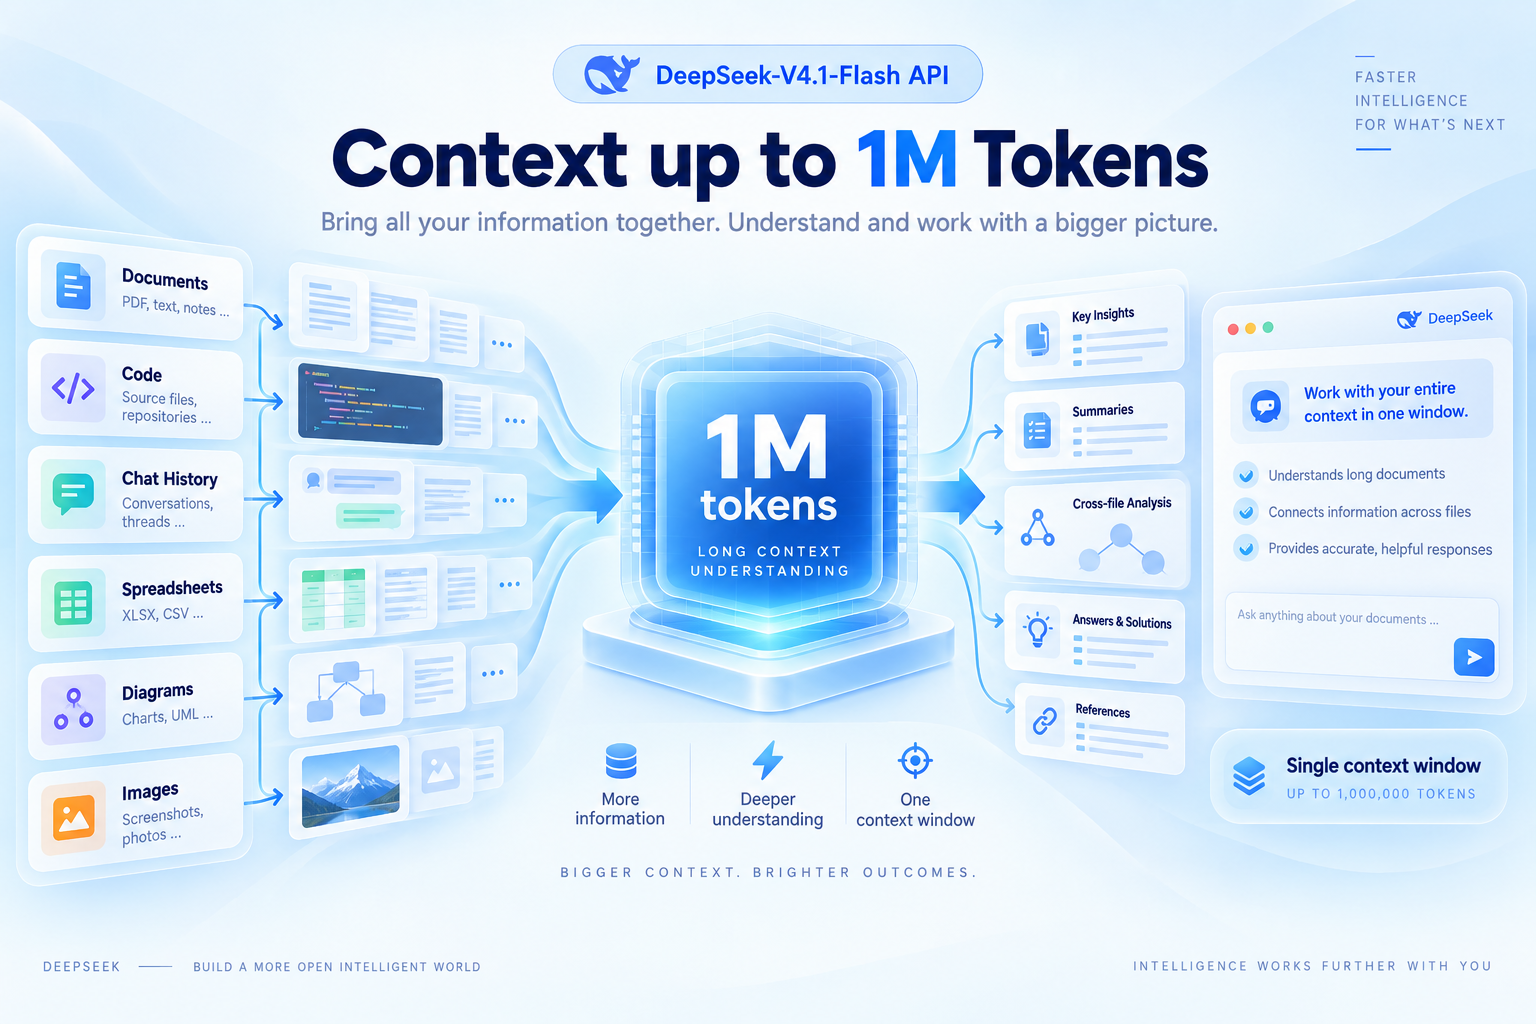
上下文扩展到 100 万 token
面对信息密集的负载,DeepSeek 4.1 Flash 支持最长 100 万 token 的上下文,能在单个上下文窗口中处理大得多的文本、代码、对话历史和多模态信息。
压缩 KV 缓存,负载更高效
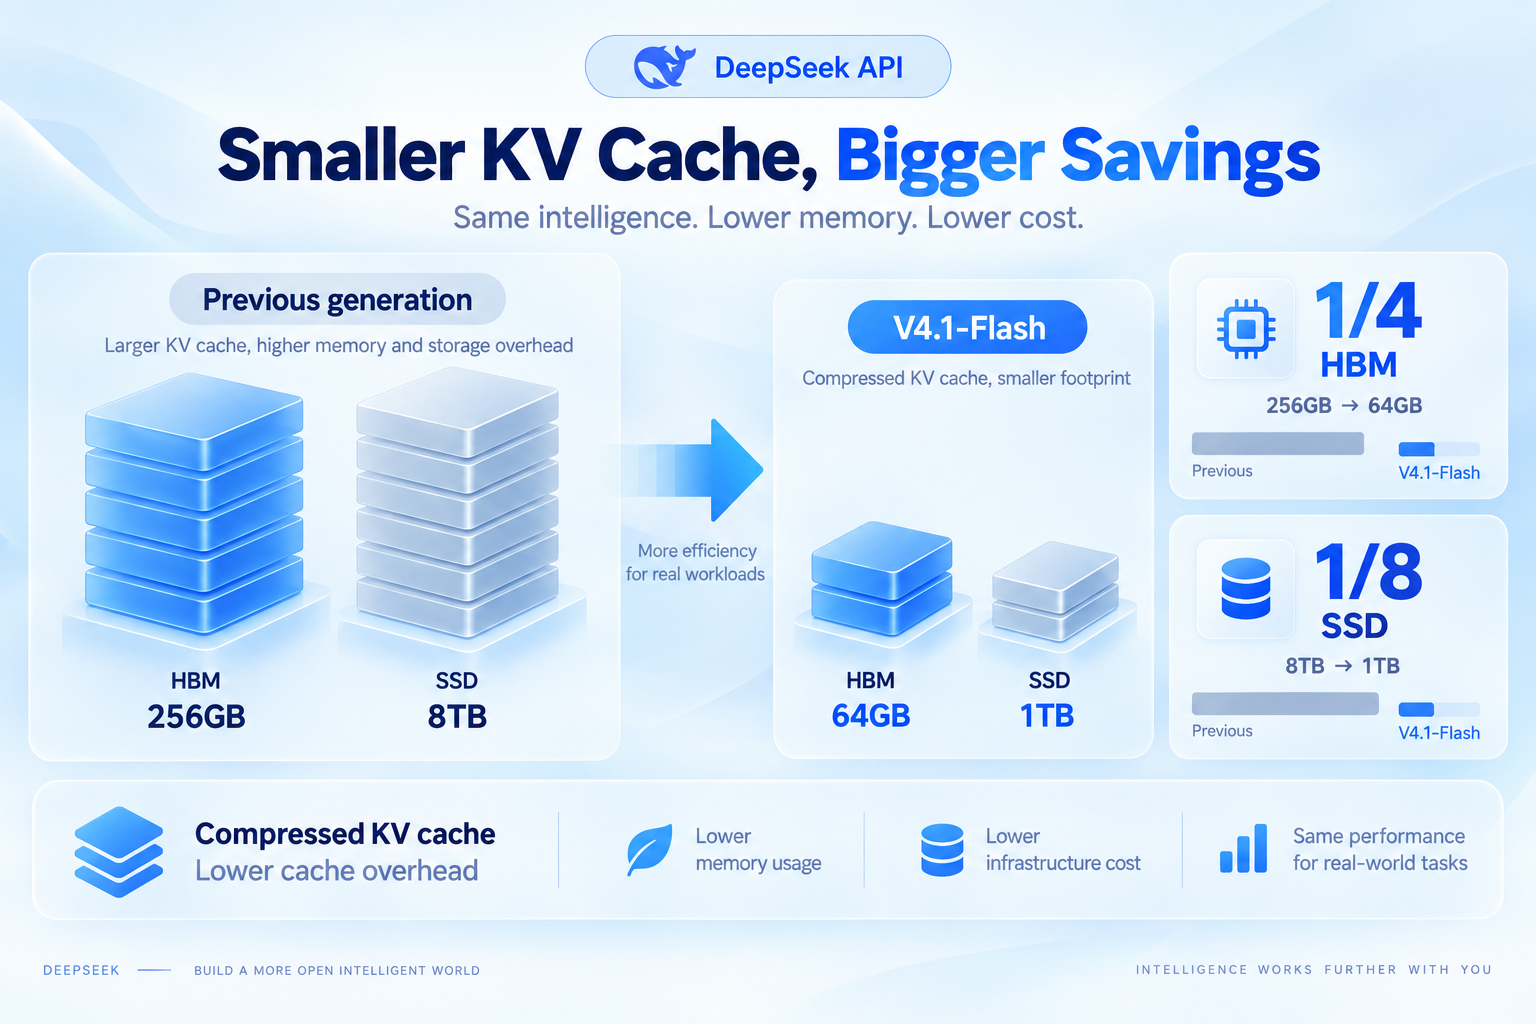
与上一代 V4-Flash 相比,V4.1-Flash 的持久化 KV 缓存大幅缩小。DeepSeek 表示,新设计只需约四分之一的 HBM 和八分之一的 SSD 存储,降低了处理或复用大上下文的负载的缓存开销。
高吞吐,适合智能体负载
DeepSeek-V4.1-Flash 专为更快的推理和更高的吞吐而设计,因果编码器–解码器架构也提升了输入密集型智能体负载的效率,特别适合涉及长提示词、反复处理上下文、工具交互、编程和多步执行的应用。

DeepSeek-V4.1-Flash 在高难度任务上的表现
DeepSeek-V4.1-Flash 的基准结果体现的是在多种高难度负载上的全面提升,而不只是某一项能力。与上一代 V4-Flash 相比,它在编程、仓库级软件工程、终端任务、自动化和工具辅助推理上成绩更好,在更广泛的推理和多模态评测上也保持竞争力。下表展示它在完整基准集上与其他主流模型的对比。
| 评测项 | DeepSeek V4.1-Flash | DeepSeek V4-Pro 0813 | DeepSeek V4-Flash 0731 | GLM 5.3 | Kimi K3 | GPT 5.6-Sol | Claude Opus 5 |
|---|---|---|---|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 | 88.1 | 92.9 | 94.1 | 93.4 |
| HLE | 36.8 (39.1*) | 42.7* | 37.8* | 42.0* | 43.5 | 44.5 | 56.3 |
| Codeforces(评分) | 3471 | 3348 | 3289 | — | — | — | — |
| MathArena Apex | 65.6 | 65.3 | 58.6 | — | 65.6 | — | — |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 | 88.2 | 88.3 | 88.8 | 89.1 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 | 28.3 | 17.7 | 34.4 | 43.3 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 | 37.9 | 12.6 | 39.9 | 51.8 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 | 66.9 | 67.5 | 73.0 | 74.0 |
| ProgramBench | 20.3 | 15.5 | — | 19.0 | 17.5 | 23.0 | 37.0 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 | 58.0 | 58.0 | 56.8 | 75.3 |
| CyberGym | 88.1 | 83.3 | 76.7 | 84.5 | 80.0 | 84.5 | — |
| SEC-Bench Pro | 62.8 | 56.4 | 30.9 | — | — | 74.3 | — |
| ExploitGym | 15.3 | 5.4 | 1.8 | 15.0 | — | 33.7 | 22.1 |
| HLE(使用工具) | 63.9 | 60.0 | 51.5 | 62.5 | 59.8 | — | 63.6 |
| Automation-Bench | 54.8 | 43.2 | 37.7 | 48.8 | 46.7 | 45.8 | 50.3 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 | 28.5 | 27.6 | 26.7 | 28.6 |
| Chartography(使用工具) | 78.9 | — | — | — | 68.1 | 79.9 | 84.0 |
| BabyVision(使用工具) | 89.6 | — | — | — | 85.7 | 88.9 | 94.1 |
| ZeroBench-main(使用工具) | 49.0 | — | — | — | 41.0 | 53.0 | 52.0 |
| 注 | * 表示 HLE 的纯文本子集。 | — | — | — | — | — | — |
如何开始使用 DeepSeek-V4.1-Flash API
从注册账号到测试和部署,只需简单三步:先获取 API Key,在 Playground 中验证模型,再把 DeepSeek-V4.1-Flash 接入你的应用或工作流。
- 1
1. 注册 ModelFold 并获取 API Key
注册或登录 ModelFold 账号,获取使用 DeepSeek-V4.1-Flash 所需的 API Key。妥善保管密钥,开始测试或集成时用它为请求鉴权。
- 2
2. 在 Playground 中测试
部署之前,先在 Playground 中用示例提示词和输入试用 DeepSeek V4.1 Flash,快速检查回复质量、尝试不同的指令。
- ✓
3. 部署到你的应用
测试完成后,把 DeepSeek 4.1 Flash 集成到你的产品、智能体、后端服务或自动化流程中,按应用需求配置请求,从 Playground 实验走向可用于生产的 API 调用。
用 DeepSeek-V4.1-Flash API 可以做什么
构建编程助手
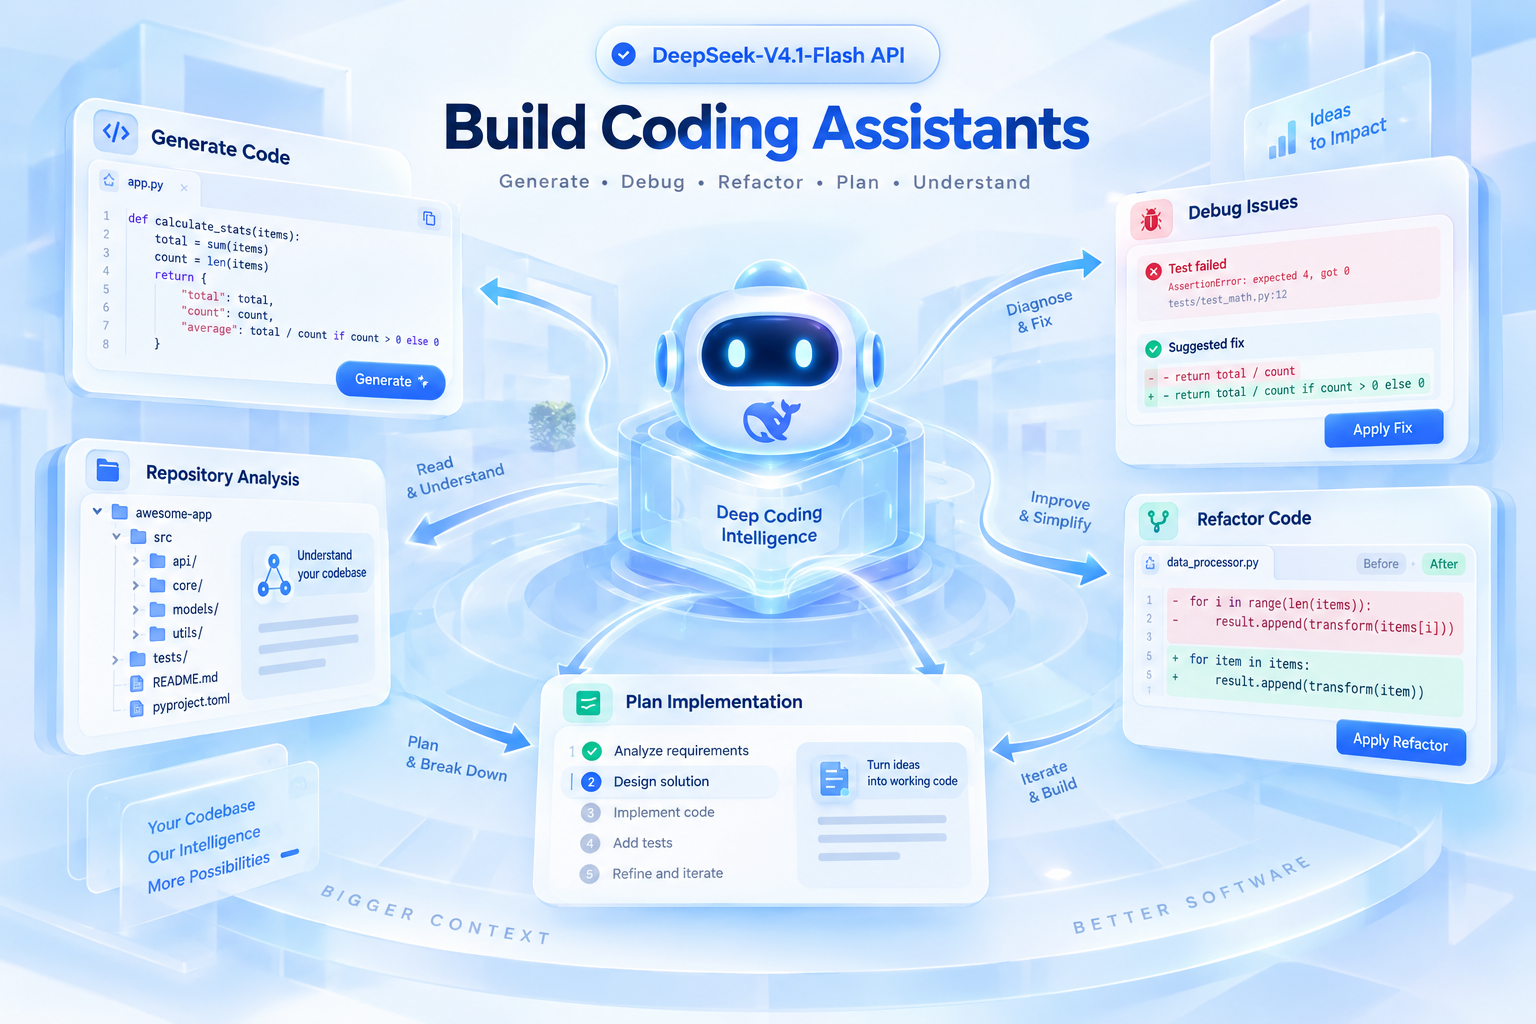
DeepSeek-V4.1-Flash 可以支撑代码生成、调试、重构、实现规划和仓库级分析。开发者可以用它构建能在更大代码上下文中工作的编程助手,从规划到迭代开发,处理更复杂的软件工程任务。
打造 AI 智能体
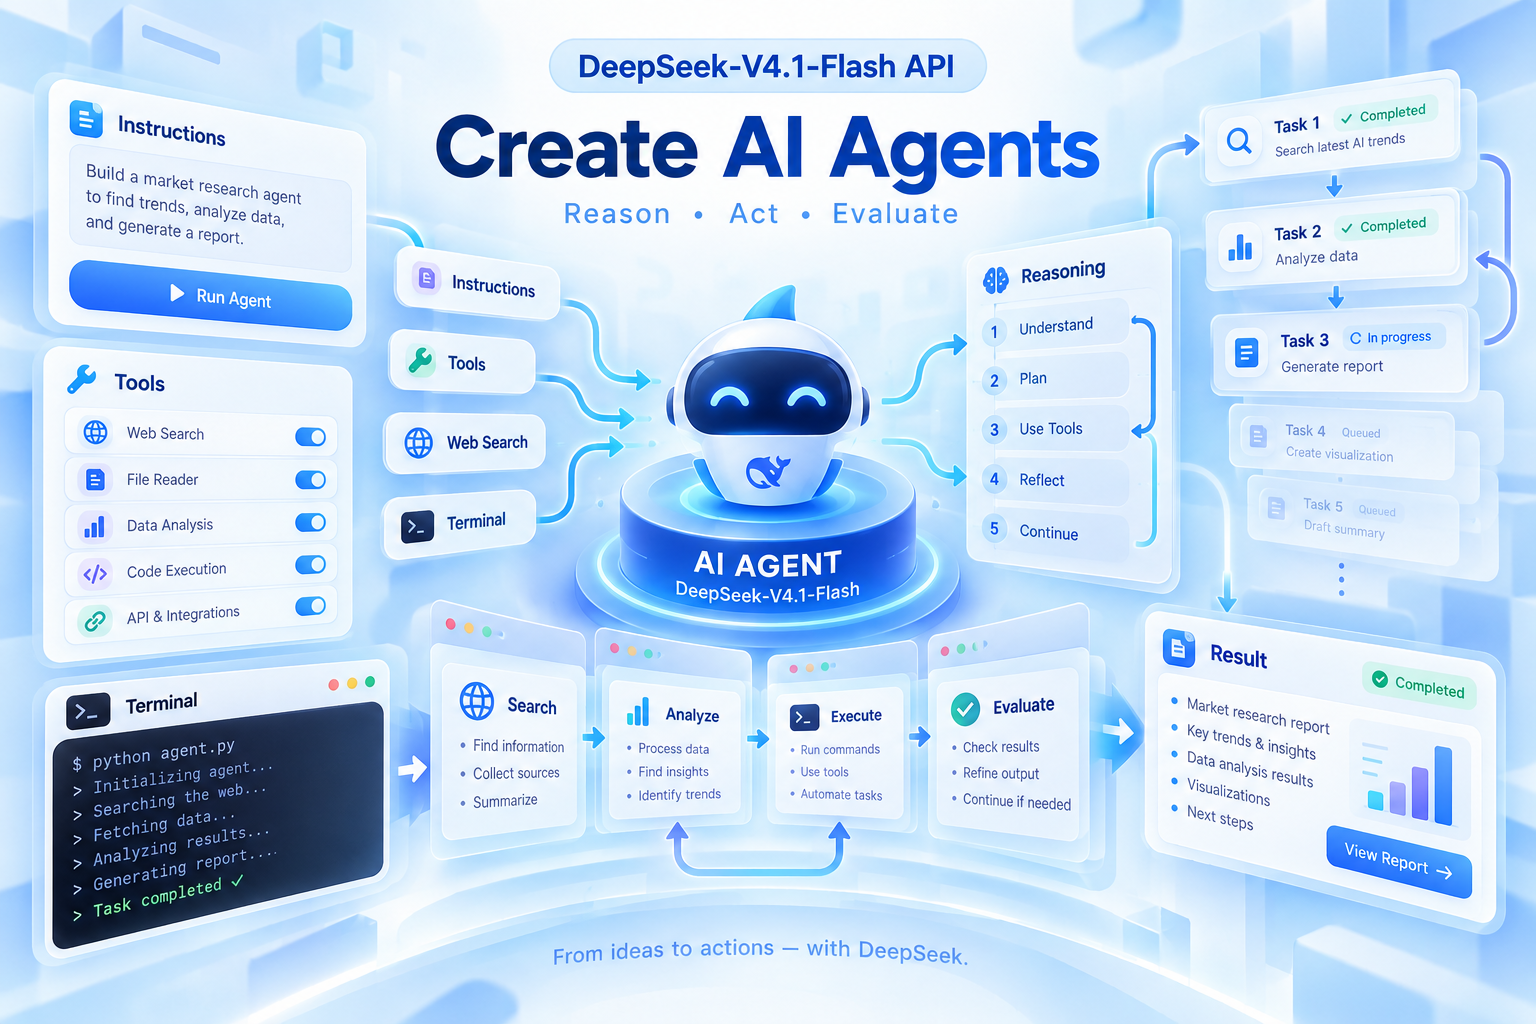
DeepSeek V4.1 Flash 适合涉及反复推理、工具交互、终端操作和多步执行的智能体工作流,能支撑理解指令、执行操作、评估中间结果并在更长任务序列中持续工作的助手。
分析视觉输入
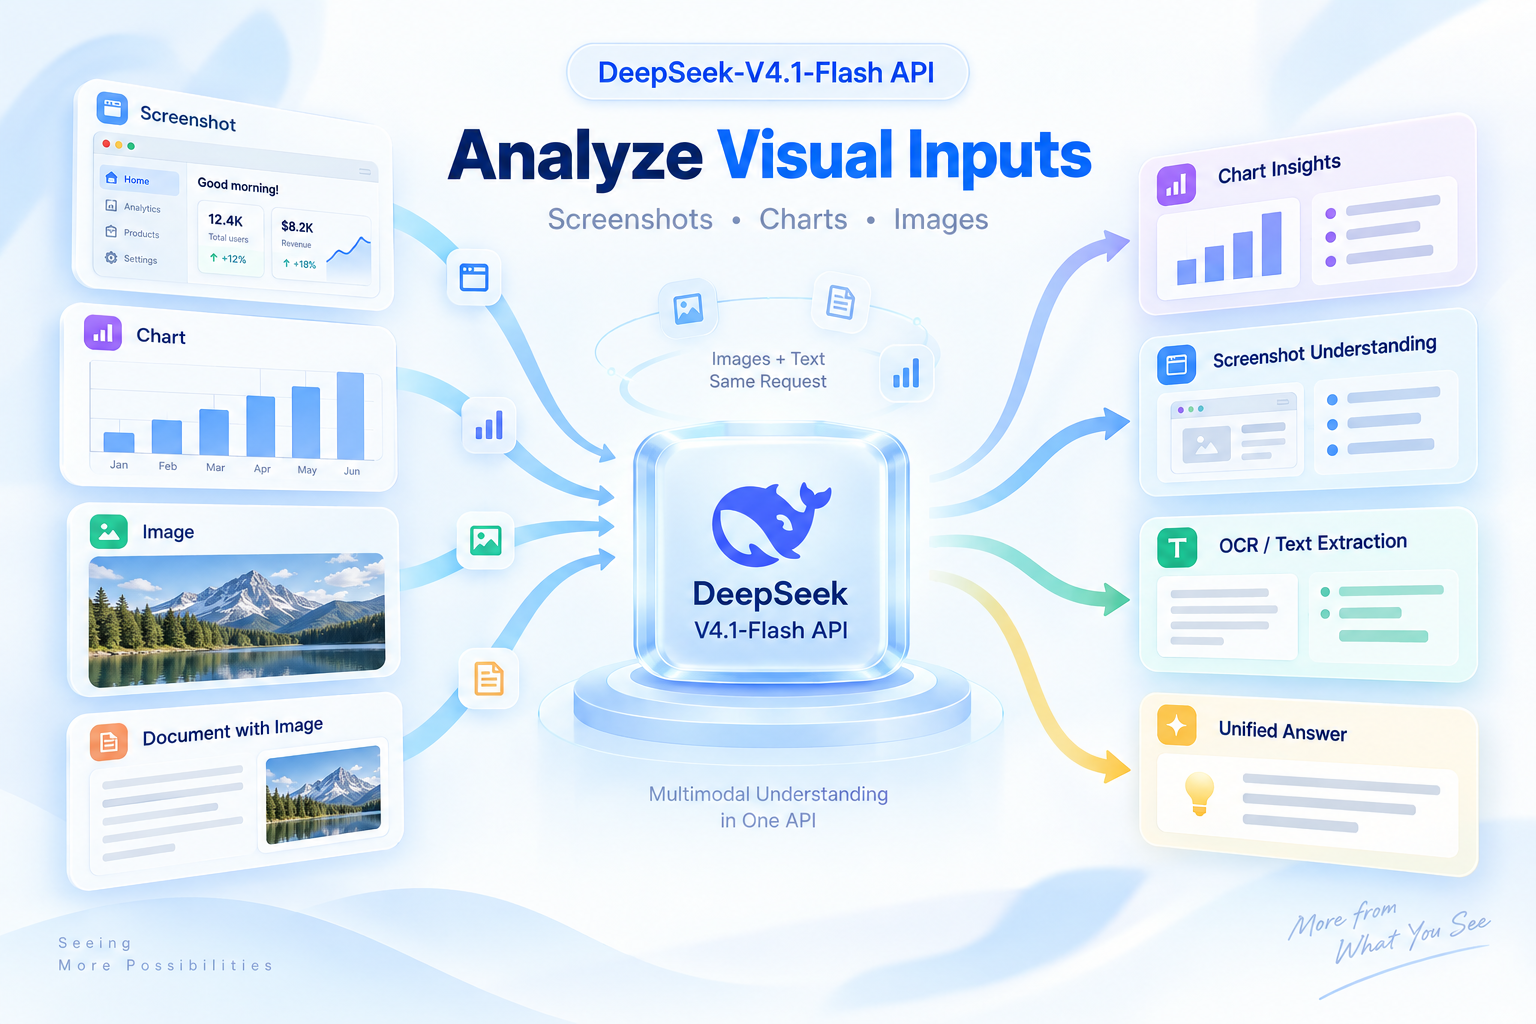
DeepSeek 4.1 Flash 原生支持图片与文本的多模态理解。开发者可以用它构建在同一请求中解读截图、识别图中文字、分析图表、推理其他视觉内容的工作流。
处理长上下文工作流
借助 V4.1-Flash,DeepSeek 可以支撑长对话、研究流程、大型代码库理解等信息密集型任务。更大的上下文容量让复杂工作流中能保留更多相关信息,无需不断把输入拆成小块。
为什么选择 ModelFold 集成 DeepSeek-V4.1-Flash API
一个 OpenAI 兼容端点
用模型 ID deepseek-v4-1-flash 调用 POST https://ai.modelfold.online/v1/chat/completions,以 Authorization: Bearer YOUR_API_KEY 鉴权,传入 OpenAI 风格的 messages 数组即可。完整结果在一个 JSON 中返回,附带 token 用量和本次扣除的积分。价格见上方定价部分。
默认开启思考,可在 Playground 中调整
DeepSeek-V4.1-Flash 默认会先思考再作答。在本页的 Playground 中,你可以关闭思考以获得更快、更省的回复,或选择不同的推理强度,在集成前对比效果。
与所有模型相同的集成方式
ModelFold 上所有对话模型都使用同一个端点和请求格式,只需改模型 ID,就能在 DeepSeek、Claude、GPT、Gemini、Grok 和 Kimi 之间切换,一个 API Key、一个钱包。
只为实际用量付费
按 token 计费、无需订阅,每次调用的确切费用都会显示在返回结果和钱包流水中,用真实提示词测试 DeepSeek V4.1 Flash 只需几个积分。
DeepSeek-V4.1-Flash API 常见问题
DeepSeek-V4.1-Flash 是什么?⌄
DeepSeek-V4.1-Flash 是一款多模态混合专家模型,基于 5520 亿参数主干和因果编码器–解码器架构。它对输入和输出进行非对称计算:处理输入时约激活 80 亿参数,生成时约激活 160 亿参数,同时支持原生视觉理解和长上下文任务。
用 DeepSeek-V4.1-Flash API 可以做什么?⌄
可以用于编程助手、AI 智能体、终端工作流、视觉理解、研究工具、长上下文推理,以及其他需要多步执行的应用。它的设计特别适合涉及大输入或反复调用模型的负载。
DeepSeek V4.1 Flash 支持图片输入吗?⌄
模型本身具备原生多模态能力,可以把图片和文本提示词结合使用,用来解读截图、识别图中文字、分析图表和推理其他视觉内容。(具体通过 ModelFold API 支持哪些输入格式,请以接口文档为准。)
DeepSeek 4.1 Flash 的上下文窗口有多大?⌄
最长支持 100 万 token,为大型代码库、长对话历史、研究资料等信息密集型输入在单个上下文中留出更多空间。
DeepSeek-V4.1-Flash 为什么采用非对称架构?⌄
非对称的因果编码器–解码器设计让它对输入和输出使用不同的实际计算量:处理输入时约激活 80 亿参数,生成时约激活 160 亿参数,在保留更大 MoE 主干容量的同时减少计算。
DeepSeek 适合智能体应用吗?⌄
适合。V4.1-Flash 专为涉及反复推理、工具交互、终端任务和多步执行的负载设计,更高吞吐的架构和更低的缓存需求,尤其适合在长任务序列中处理大量上下文的智能体。
如何在 ModelFold 上使用 DeepSeek-V4.1-Flash API?⌄
注册 ModelFold 账号、获取 API Key,先用 Playground 或接口文档测试 DeepSeek-V4.1-Flash,请求配置好后再接入你的应用、后端服务、编程助手或智能体工作流。
| 输入 | 30 积分 /百万 token≈ $0.15 |
| 输出 | 118.75 积分 /百万 token≈ $0.59 |
按 token 计费:输入、输出分别计价,思考过程的 token 按输出计。Playground 与 API 扣费口径完全一致。
查看接口文档 →curl https://ai.modelfold.online/v1/chat/completions \
-H "Authorization: Bearer $MODELFOLD_API_KEY" \
-H "Content-Type: application/json" \
-d '{"model":"deepseek-v4-1-flash","messages":[{"role":"user","content":"Hello"}]}'