 ModelFold
grok-4-7
Grok 4.7 是面向编程、推理、长链路任务和专业知识工作的高级模型,自我校验更强、长上下文管理更好,支持 50 万 token 上下文。
定价: 输入 200 积分 / 百万 token(≈ $1.00),输出 600 积分 / 百万 token(≈ $3.00)。
今天想聊点什么?
更多对话模型
Grok 的更多模型
Grok 4.7 API —— 在 ModelFold 上用 xAI Grok 4.7 开发
在 ModelFold 上使用 Grok 4.7 API,进行高级编程、推理、智能体工作流和专业知识工作。新用户可用积分免费试用,并以灵活的价格集成到你的应用中。
Grok 4.7 API 能力一览
胜任长链路任务
需要多步骤和长推理的任务可以交给 Grok 4.7。它的训练使用了更难的题目组合,更偏重耗时较长的任务,因此适合多步编程、研究、分析和基于智能体的任务执行等工作流。
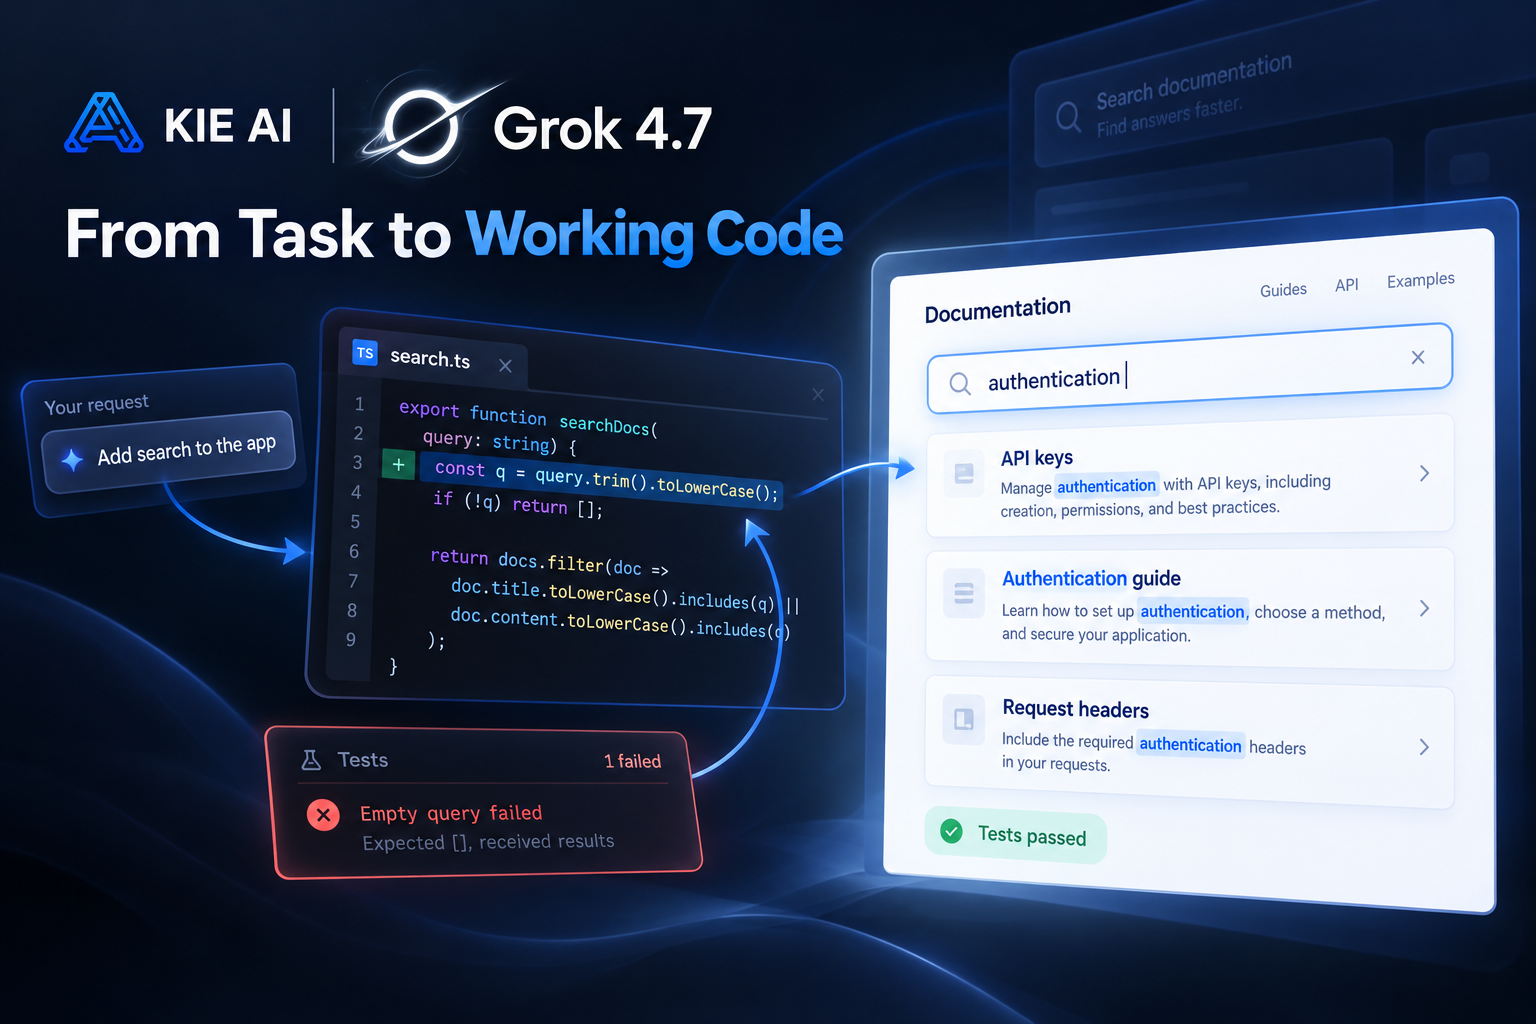
更强的自我校验
Grok 4.7 会更仔细地检查自己的工作,自我校验能力更强,能复核中间结果、更有效地处理困难任务。在编程、研究、分析等对准确性和一致性有要求的多步任务中,开发者都能用上这项能力。
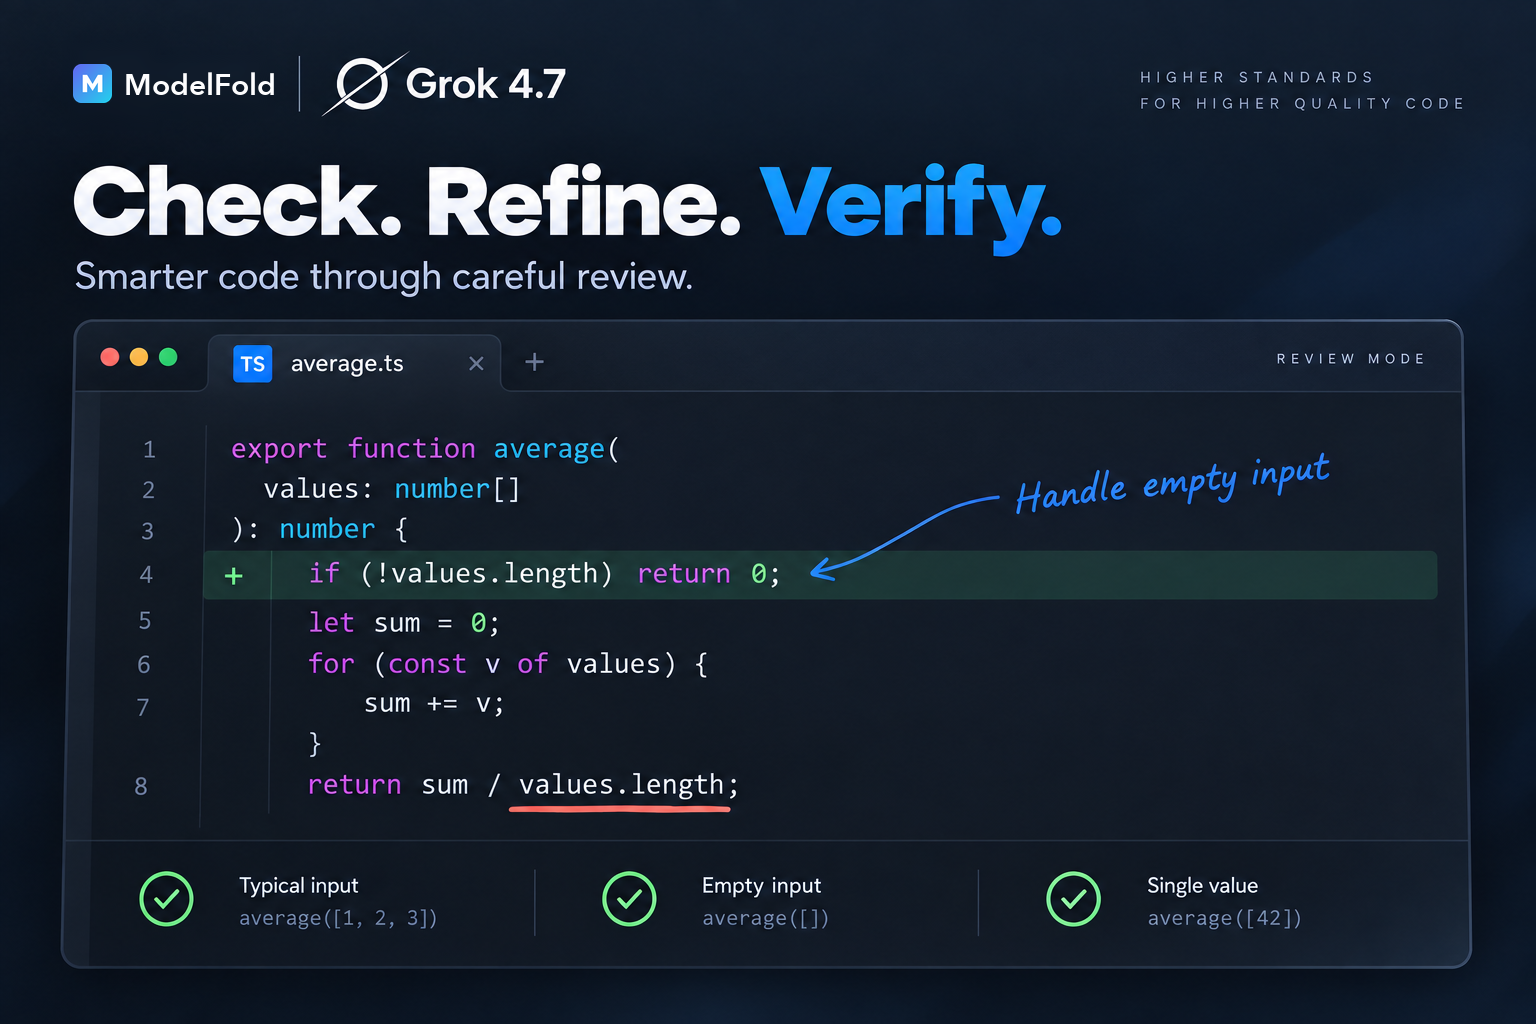
构建高级编程工作流
Grok 4.7 能胜任高要求的软件工程任务,从代码生成、调试到仓库分析和较长的开发流程。它在关键软件工程基准上的表现强于 Grok 4.6,很适合编程助手、开发者工具和智能体编程应用。
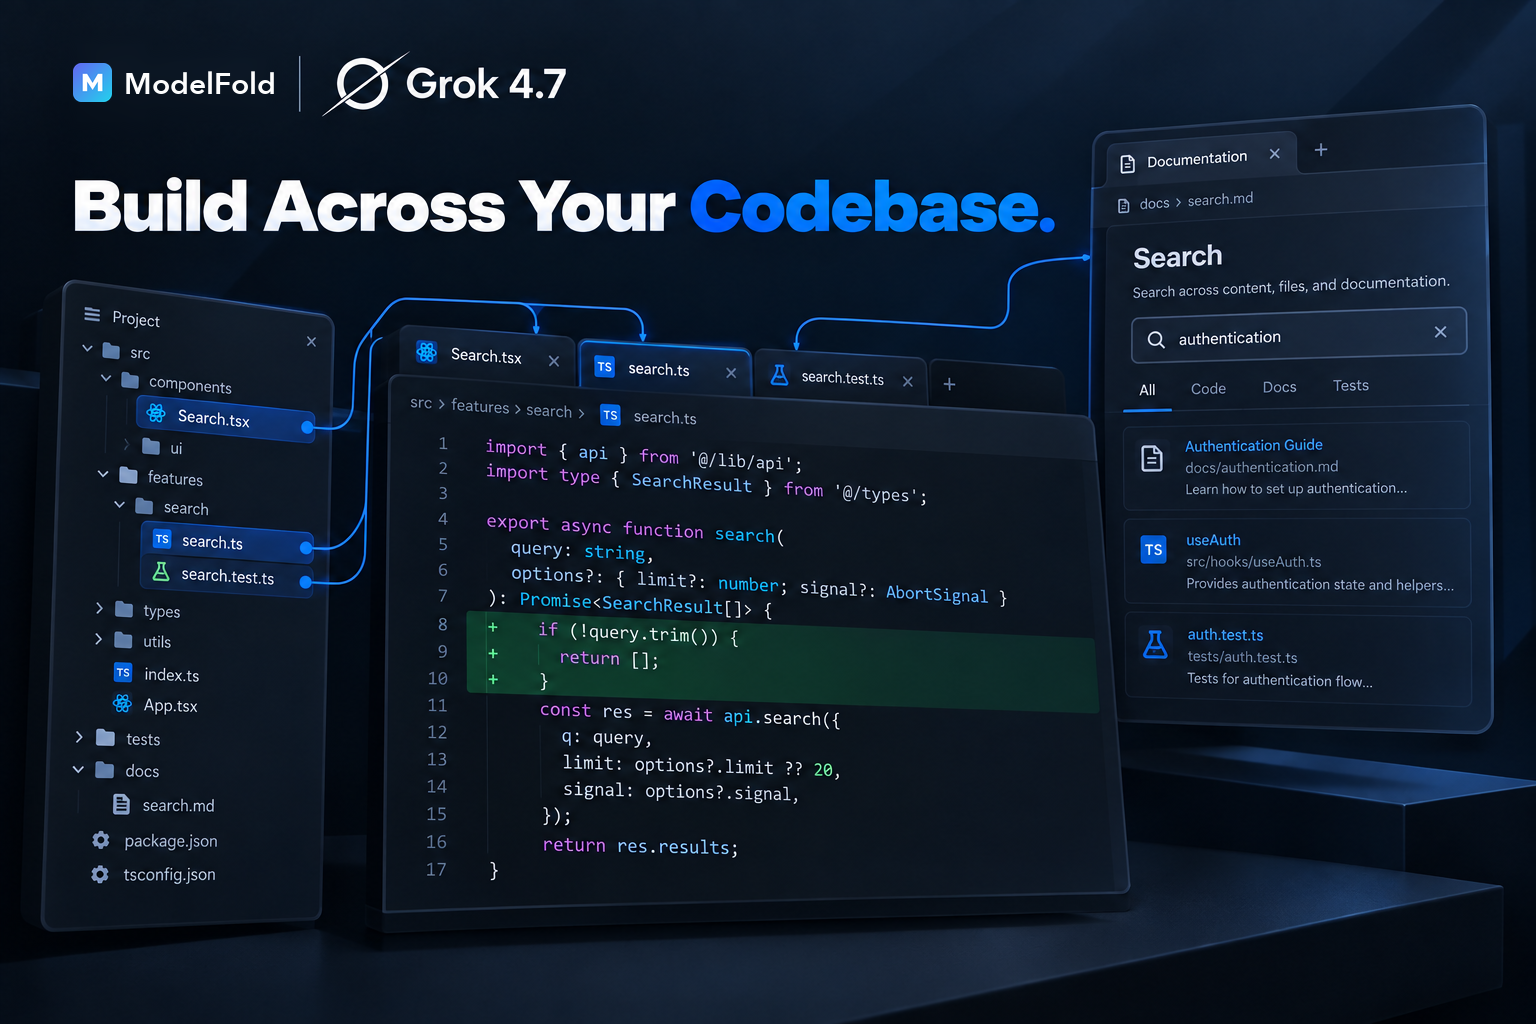
50 万 token 上下文窗口
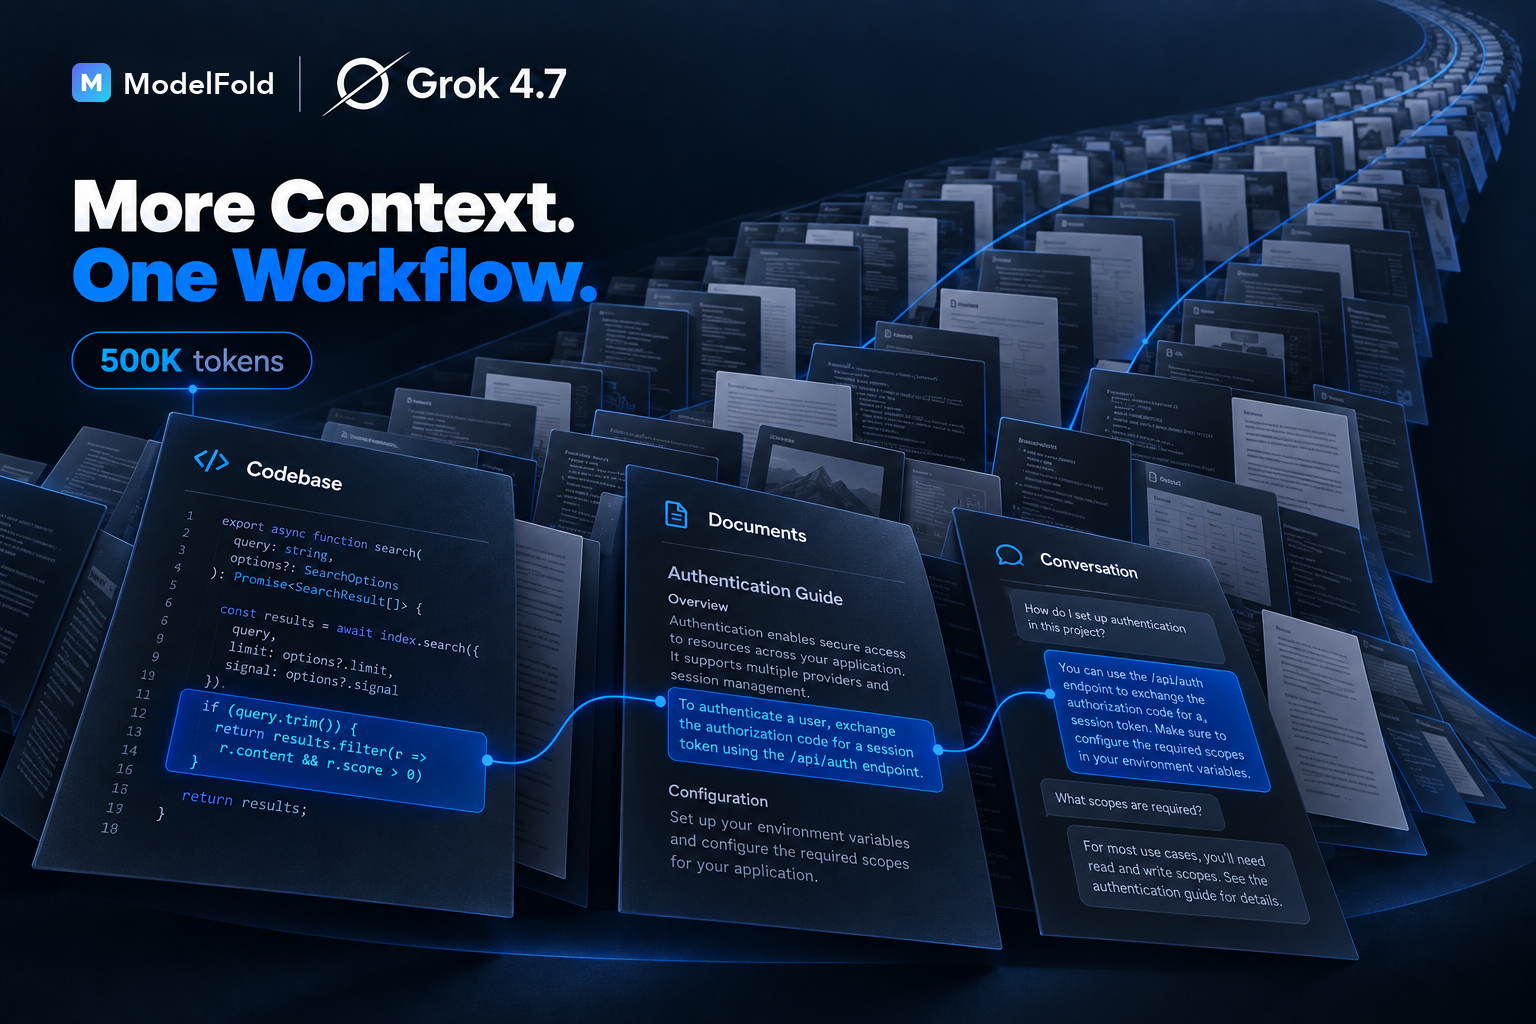
单个 Grok 4.7 工作流最多可处理 50 万 token 的上下文。大上下文窗口让它能处理大型代码库、长文档、详细指令和较长的对话历史,开发者可以给模型更多相关上下文,而不必把复杂输入拆成许多小请求。
四档推理强度可控
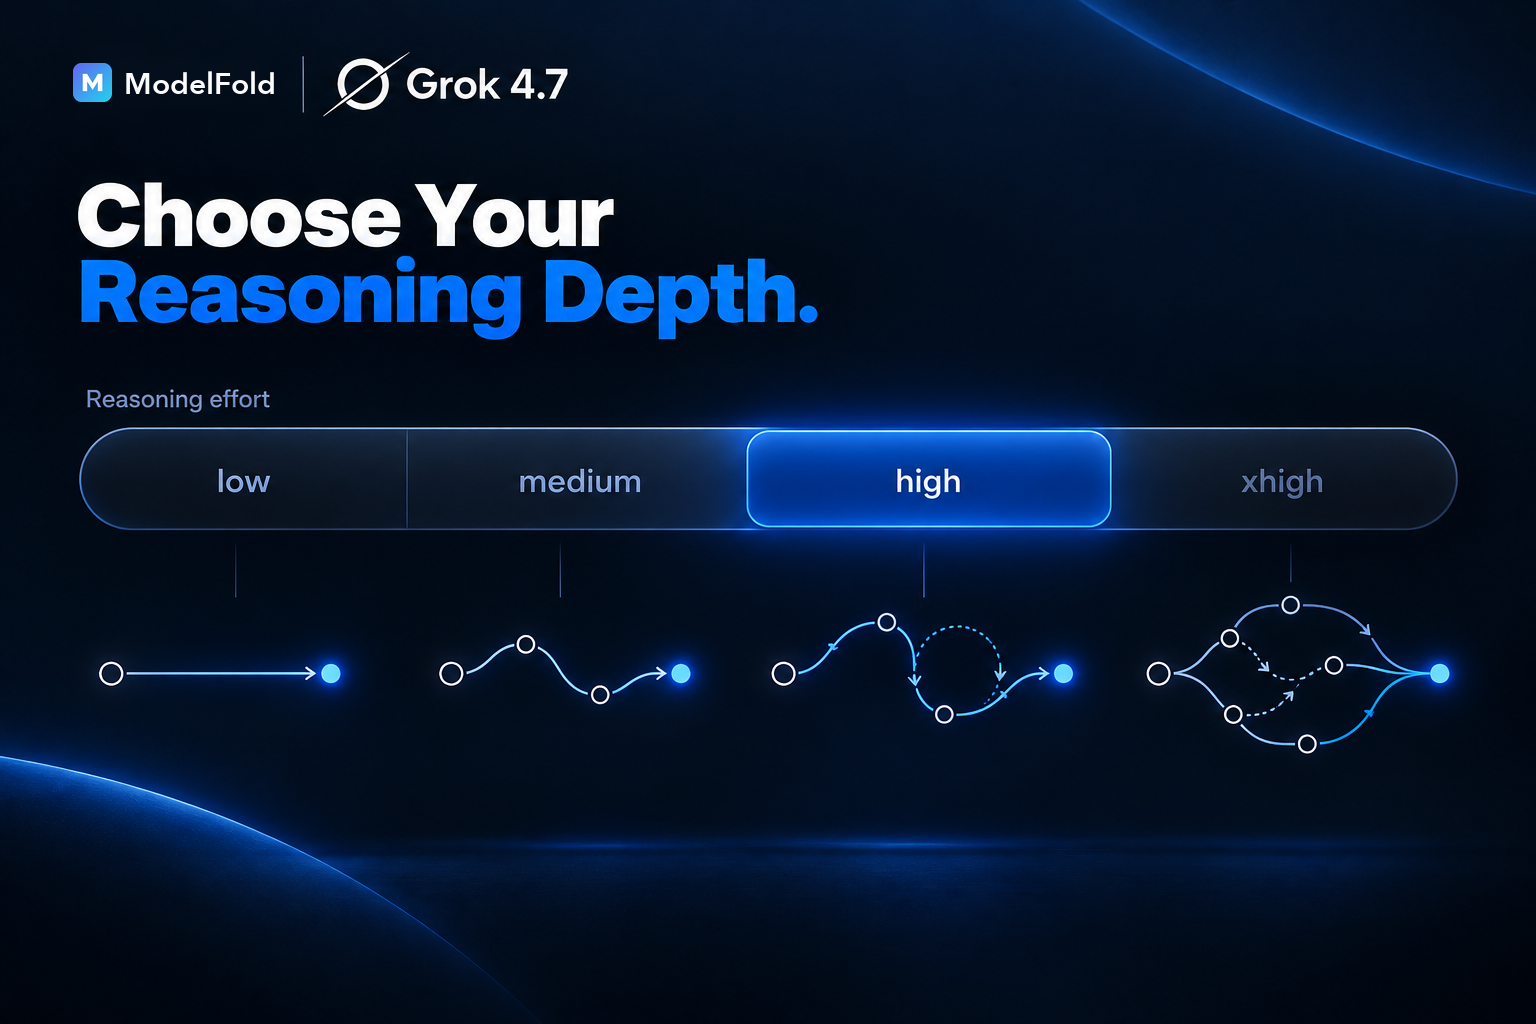
按每个应用的需要匹配推理深度:Grok 4.7 支持 low、medium、high 和 xhigh 四档推理强度。简单或对延迟敏感的任务用低档,需要更深入分析和多步推理时用高档。
胜任专业知识工作
Grok 4.7 不止于编程,也能处理高要求的专业任务:它在覆盖数小时办公工作、电气工程、法律任务等知识密集型负载的基准上都有提升。可以在 ModelFold 上用它驱动研究、文档分析、专业内容流程,以及需要跨专业信息进行更强推理的 SaaS 工具。

Grok 4.7 API 基准表现
编程和专业工作成绩亮眼
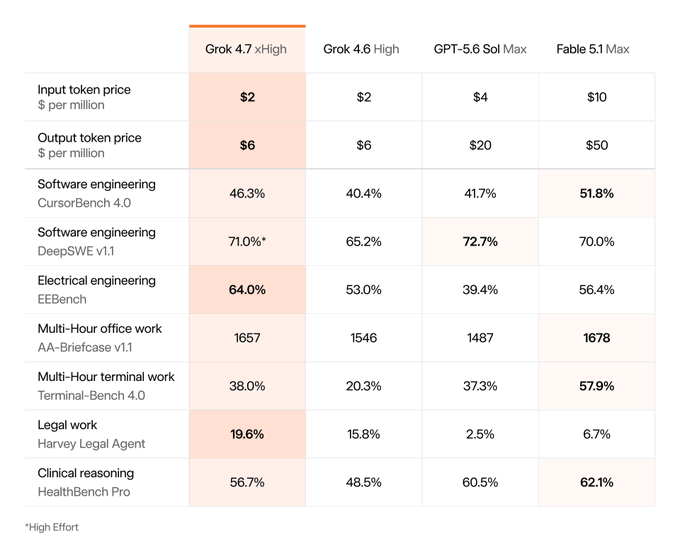
根据 SpaceXAI 公布的基准结果,Grok 4.7 在 CursorBench 4.0 上得分 46.3%,DeepSWE v1.1(高推理强度)为 71.0%,EEBench 为 64.0%,AA Briefcase v1.1 为 1,657。这些基准分别评估软件工程、多步编程任务、电气工程和专业办公工作等不同领域。
Grok 4.7 vs Grok 4.6:有什么变化?
与 Grok 4.6 相比,Grok 4.7 使用了全新的、更大的基座模型,并进行了更长的、聚焦更难的长时任务的强化学习训练。它还改进了自我校验和长上下文管理,在编程、工程、专业知识工作和其他复杂工作流中表现更好。官方基准显示,Grok 4.7 在下列全部七项测试中得分都更高。
| 评测项 | Grok 4.7 | Grok 4.6 |
|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% |
| DeepSWE v1.1 | 71.0%* | 65.2% |
| EEBench | 64.0% | 53.0% |
| AA Briefcase v1.1 | 1,657 | 1,546 |
| Terminal-Bench 4.0 | 38.0% | 20.3% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% |
| HealthBench Professional | 56.7% | 48.5% |
| Grok 4.7 的 DeepSWE v1.1 成绩为高推理强度下的结果。结果基于 SpaceXAI 公布的基准。 |
如何在 ModelFold 上使用 Grok 4.7 API
- 1
第 1 步:在 Playground 免费试用
先在 ModelFold Playground 中免费试用 Grok 4.7:输入自己的提示词,看看它在编程、推理、长上下文任务和知识工作上的表现,再决定发 API 请求。无需先配置集成,就能快速体验 xAI Grok 4.7。
- 2
第 2 步:获取 API Key
注册或登录 ModelFold 账号并生成 API Key,用它调用 Grok 4.7,把模型接入你的 SaaS 产品、AI 智能体、开发者工具或后端流程。
- 3
第 3 步:发送第一个请求
选择 Grok 4.7,通过 API 发送第一个请求:填入提示词、配置可用参数,用你自己的场景测试回复,再把集成推向生产。
- ✓
第 4 步:集成到你的应用
把 Grok 4.7 接入你的应用并开始开发,用它驱动编程智能体、SaaS 助手、研究工具、文档流程和其他 AI 功能。随着产品增长扩展集成,同时让 Grok 4.7 保留在现有的应用流程中。
在 ModelFold 上用 Grok 4.7 API 构建强大的 AI 应用
构建 AI 编程智能体
用 Grok 4.7 打造编程副驾、调试助手、代码审查工具和自主开发智能体,让你的应用能理解代码、推理软件工程问题,并在较长的开发任务中持续工作。它很适合需要的不只是简单代码补全的开发者产品。
打造 SaaS AI 助手
把 xAI Grok 4.7 带进 SaaS 产品、效率平台、内部工具和面向客户的 AI 功能中,驱动能理解详细请求、解决复杂问题、在多步流程中支持用户的助手。
分析长文档
构建处理大型文档和大量上下文输入的应用。凭借 50 万 token 上下文窗口,Grok 4.7 能支撑涉及报告、技术文档、合同、研究资料和大量文本的工作流,适合文档分析、摘要、信息抽取和问答。
自动化专业工作
用 Grok 4.7 在专业工作流中自动化知识密集型任务:构建文档创作、分析、报告、研究等需要持续推理的工具。开发者可以把它接入内部系统或 SaaS 产品,在保持复杂信息上下文的同时减少重复劳动。
驱动研究类应用
打造能处理详细信息、在大量输入中串联洞察的研究助手和知识应用。Grok 4.7 能支撑研究综述、问答、文档探索,以及用户需要的不只是快速生成回复的知识密集型工作流。
构建会用工具的 AI 智能体
打造从推理走向行动的 AI 智能体:在你自己的编排代码中调用 Grok 4.7,把它与外部 API、数据库和应用工具连接起来,完成真实的工作流。可用于 SaaS 自动化、开发者智能体、研究系统,以及其他需要与模型之外的工具交互的应用。
Grok 4.7 vs Fable 5.1 vs GPT-6 Astra
Grok 4.7 vs Fable 5.1:编程与长链路工作
两款模型都瞄准复杂编程和长链路工作。SpaceXAI 公布 Grok 4.7 在 DeepSWE v1.1(高推理强度)上得分 71.0%,Fable 5.1 为 70.0%;而 Fable 在其他几项编程和专业工作基准上领先。Artificial Analysis 的独立测试也把两者都列为智能体负载的领先模型。
Grok 4.7 vs GPT-6 Astra:性能、效率与成本
独立测试显示两者的取舍不同:在 Artificial Analysis 智能指数上,GPT-6 Astra Max 为 53,Grok 4.7 xHigh 为 46;而 Grok 4.7 在部分长链路专业工作评测上成绩更高,且每 token 价格更低。 ModelFold 通过一个 API 平台同时支持 Grok 4.7、Fable 5.1、GPT-6 Astra 等主流模型,方便你为不同负载测试和选择模型。
为什么在 ModelFold 上使用 Grok 4.7 API
一个 OpenAI 兼容端点
grok-4-7 通过 POST https://ai.modelfold.online/v1/chat/completions 调用,这是一个 OpenAI 兼容端点:传入 messages 数组,一次返回完整 JSON,附带 token 用量和本次扣除的积分。输入和输出 token 的价格见上方定价部分。
在 Playground 中调整推理强度
Grok 4.7 的推理强度(low、medium、high 或 xhigh)可以在本页 Playground 中设置,集成前先对比深度和速度。ModelFold 新用户可获得 80 个免费测试积分。
推理按输出计费,错误使用标准 HTTP 状态码
推理 token 按输出 token 计费。ModelFold 返回标准的 HTTP 状态码——例如 API Key 无效返回 401、积分不足返回 402——上游调用失败会自动退款。
常见问题
Grok 4.7 是什么?⌄
Grok 4.7 是 SpaceXAI 的前沿模型,面向高级编程、长链路任务、推理和专业知识工作。与 Grok 4.6 相比,它使用更大的基座模型,改进了自我校验和长上下文处理,支持 50 万 token 上下文窗口。开发者可以通过 API 用它构建 AI 智能体、编程工具、SaaS 功能和其他 AI 应用。
如何在 ModelFold 上使用 Grok 4.7 API?⌄
注册 ModelFold 账号、获取 API Key,并按集成文档操作即可。接入应用之前,也可以先在 ModelFold Playground 中测试模型。
可以在 ModelFold 上免费试用 Grok 4.7 吗?⌄
可以。ModelFold 新用户可获得免费积分,用来试用 Grok 4.7、了解它的能力,再决定是否购买更多 API 用量。
Grok 4.7 的上下文窗口有多大?⌄
支持 50 万 token 上下文窗口,可以处理大型代码库、长文档、长对话和其他上下文密集的工作流。
Grok 4.7 和 Grok 4.6 有什么区别?⌄
Grok 4.7 使用了全新的、更大的基座模型,并进行了聚焦更难任务的更长强化学习训练;与 Grok 4.6 相比,自我校验和长上下文管理也更好。
Grok 4.7 API 在 ModelFold 上怎么收费?⌄
ModelFold 以灵活的按量计费提供实惠的 Grok 4.7 价格,只按实际 API 用量付费。价格可能随模型和服务更新而调整,使用前请查看 ModelFold 最新价格。
ModelFold 上还能用其他 Grok API 吗?⌄
能。ModelFold 在提供 Grok 4.7 的同时,还支持其他 Grok 模型和 Grok 图像生成 API,并持续接入最新的 Grok API,让你在一个平台上使用多种 Grok 能力。
| 输入 | 200 积分 /百万 token≈ $1.00 |
| 输出 | 600 积分 /百万 token≈ $3.00 |
按 token 计费:输入、输出分别计价,思考过程的 token 按输出计。Playground 与 API 扣费口径完全一致。
查看接口文档 →curl https://ai.modelfold.online/v1/chat/completions \
-H "Authorization: Bearer $MODELFOLD_API_KEY" \
-H "Content-Type: application/json" \
-d '{"model":"grok-4-7","messages":[{"role":"user","content":"Hello"}]}'