 ModelFold
google/gemini-3-1-flash-tts
Gemini 3.1 Flash TTS Preview 是 Google 富有表现力的文字转语音模型,生成自然的 AI 语音,并能精细控制语气、情绪、语速和说话风格。
定价: 按字数计费:每 1000 字 9 积分(不足 1000 字按 1000 字计),最低 8 积分。中文、日文、韩文估价时每字按 3 字计。
更多语音合成模型
Google 的更多模型
最新热门模型
Gemini 3.1 Flash TTS API:自然、富有表现力的语音生成
在 ModelFold 上用 Gemini 3.1 Flash TTS API 生成富有表现力的 AI 语音:声音自然、支持多语言,并能灵活控制音频的表达方式。
认识 Gemini 3.1 Flash TTS:更具表现力的 AI 语音
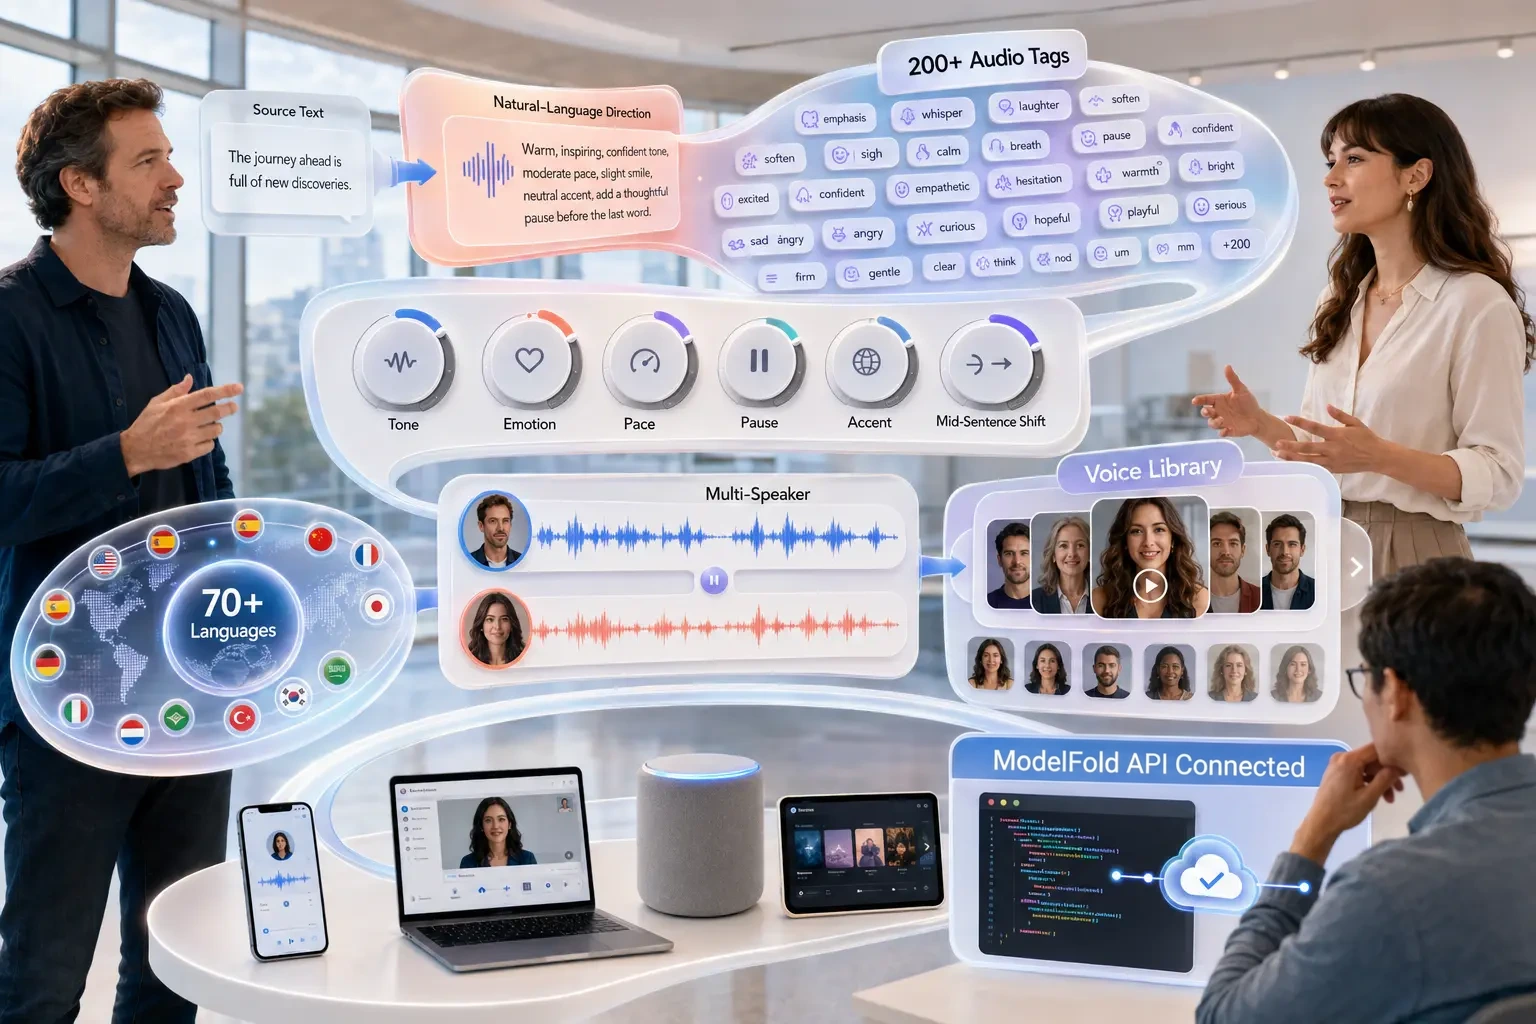
Gemini 3.1 Flash TTS 是 Google 富有表现力的文字转语音系统,能把书面内容转换成自然、高保真的音频,并精确控制发声方式。它支持 70 多种语言、丰富的预置音色和多人对话,还可以用自然语言指令和 200 多种行内音频标签来塑造语气、情绪、语速、停顿、口音和句中转折。开发者可以通过 ModelFold 上的 Gemini 3.1 Flash TTS API,把这些可控的语音生成能力集成到自己的应用中。
Gemini 3.1 Flash TTS Preview API 比 Gemini 2.5 Flash TTS API 强在哪里
与 Gemini 2.5 Flash TTS 相比,Gemini 3.1 Flash Preview TTS 带来了更好的语音质量、更细致的表达控制、更广的语言支持和更灵活的声音指导能力。这些改进着眼于让 AI 生成的语音更自然、更可定制,更适合从逼真旁白到多人互动的复杂音频体验。所有支持的功能、音色选项和集成细节请以最新的 ModelFold API 文档为准。
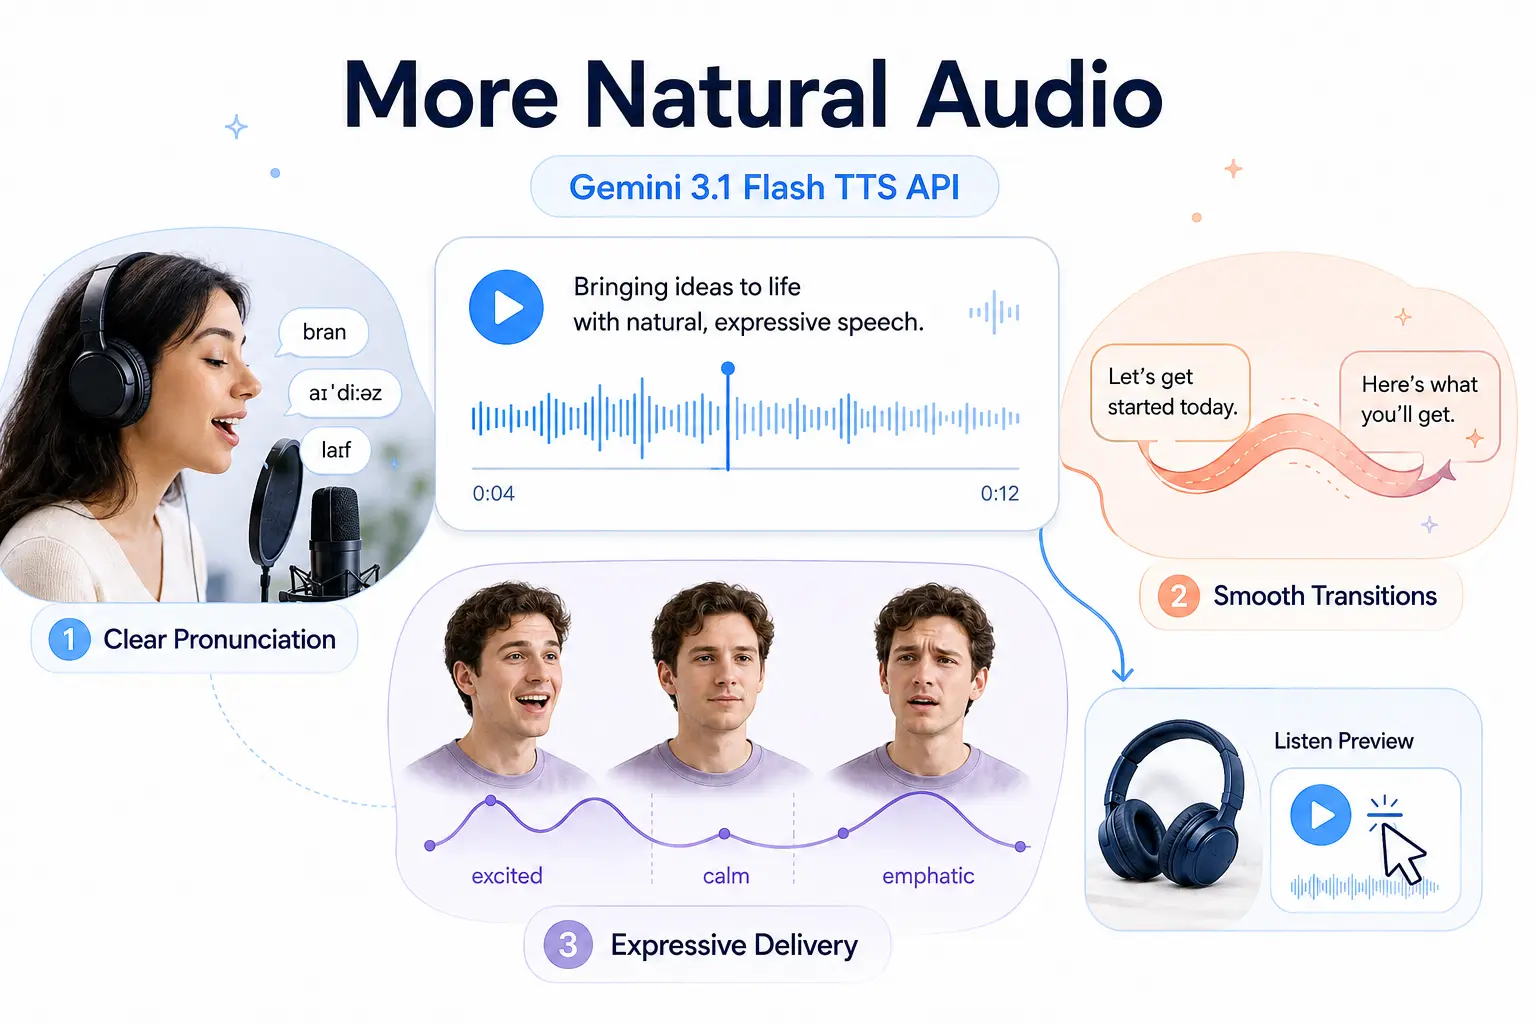
用 Gemini 3.1 Flash TTS API 生成更自然的音频
语音生成质量的提升让 Gemini 3.1 Flash TTS API 的发音更清晰、过渡更流畅、表达更有感染力。增强后的音频输出能更好地契合文本的上下文和意图,帮助开发者打造更逼真的旁白、对话式声音和互动语音体验。
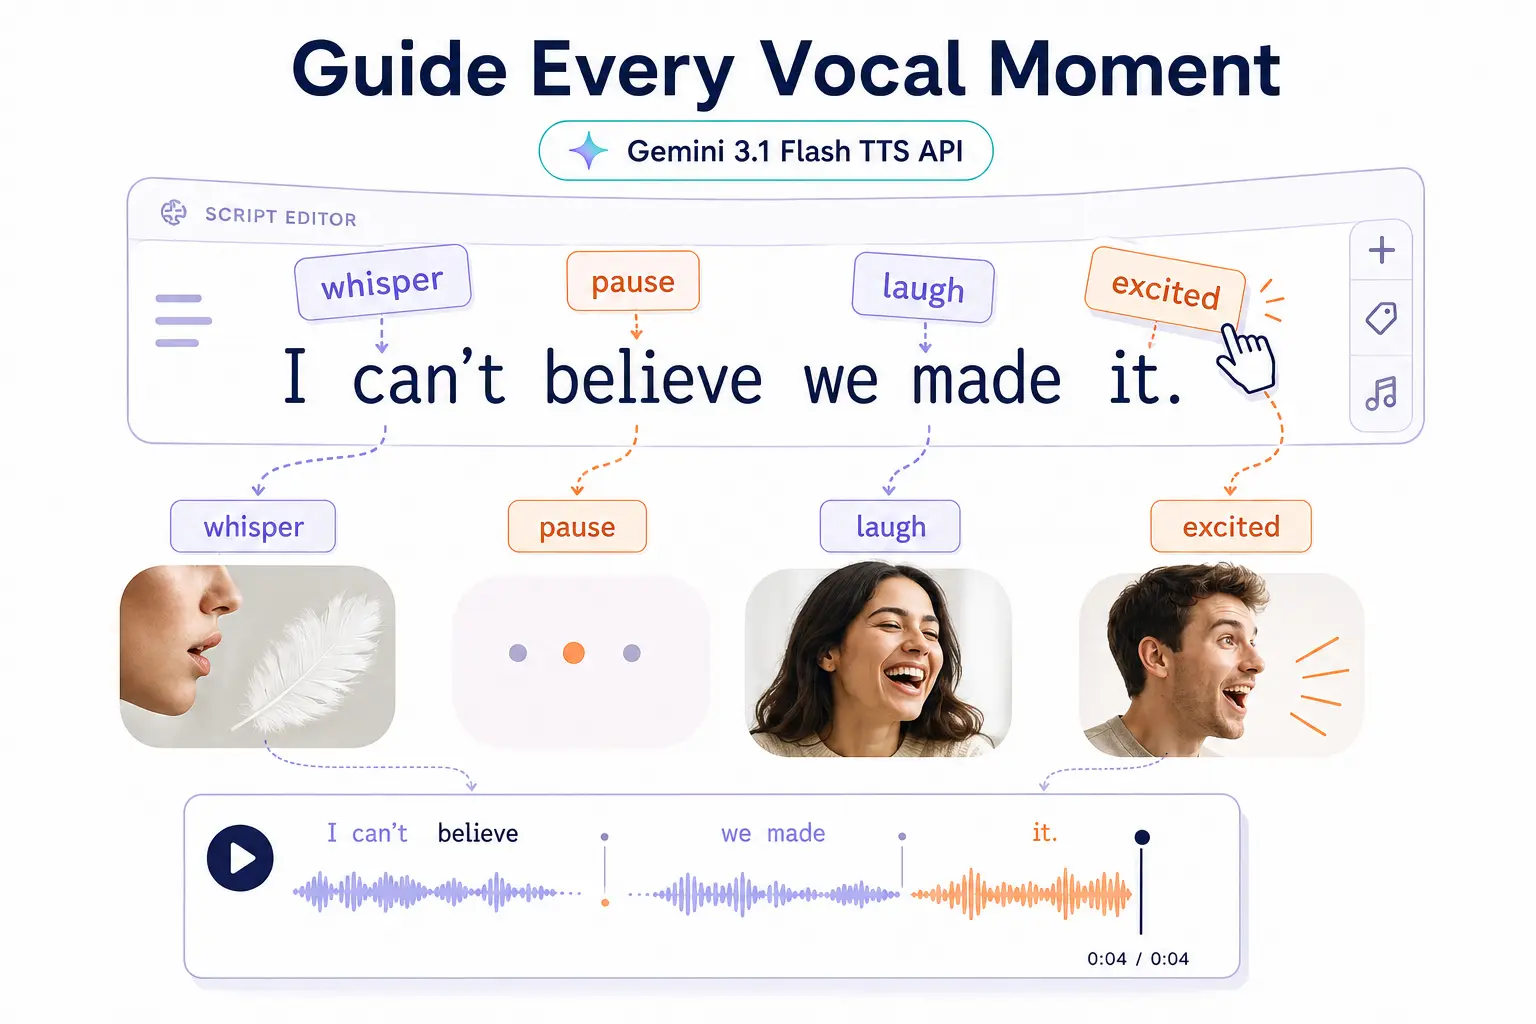
在 Gemini 3.1 Flash TTS API 中用音频标签控制表达
音频标签让开发者能更细致地引导语音表演,调整情绪、语速、停顿、耳语、笑声和其他发声元素。借助 Gemini 3.1 Flash TTS API 中的这些控制,生成的声音可以在整个剧本中自然变化,而不是始终保持一种固定的表达风格。
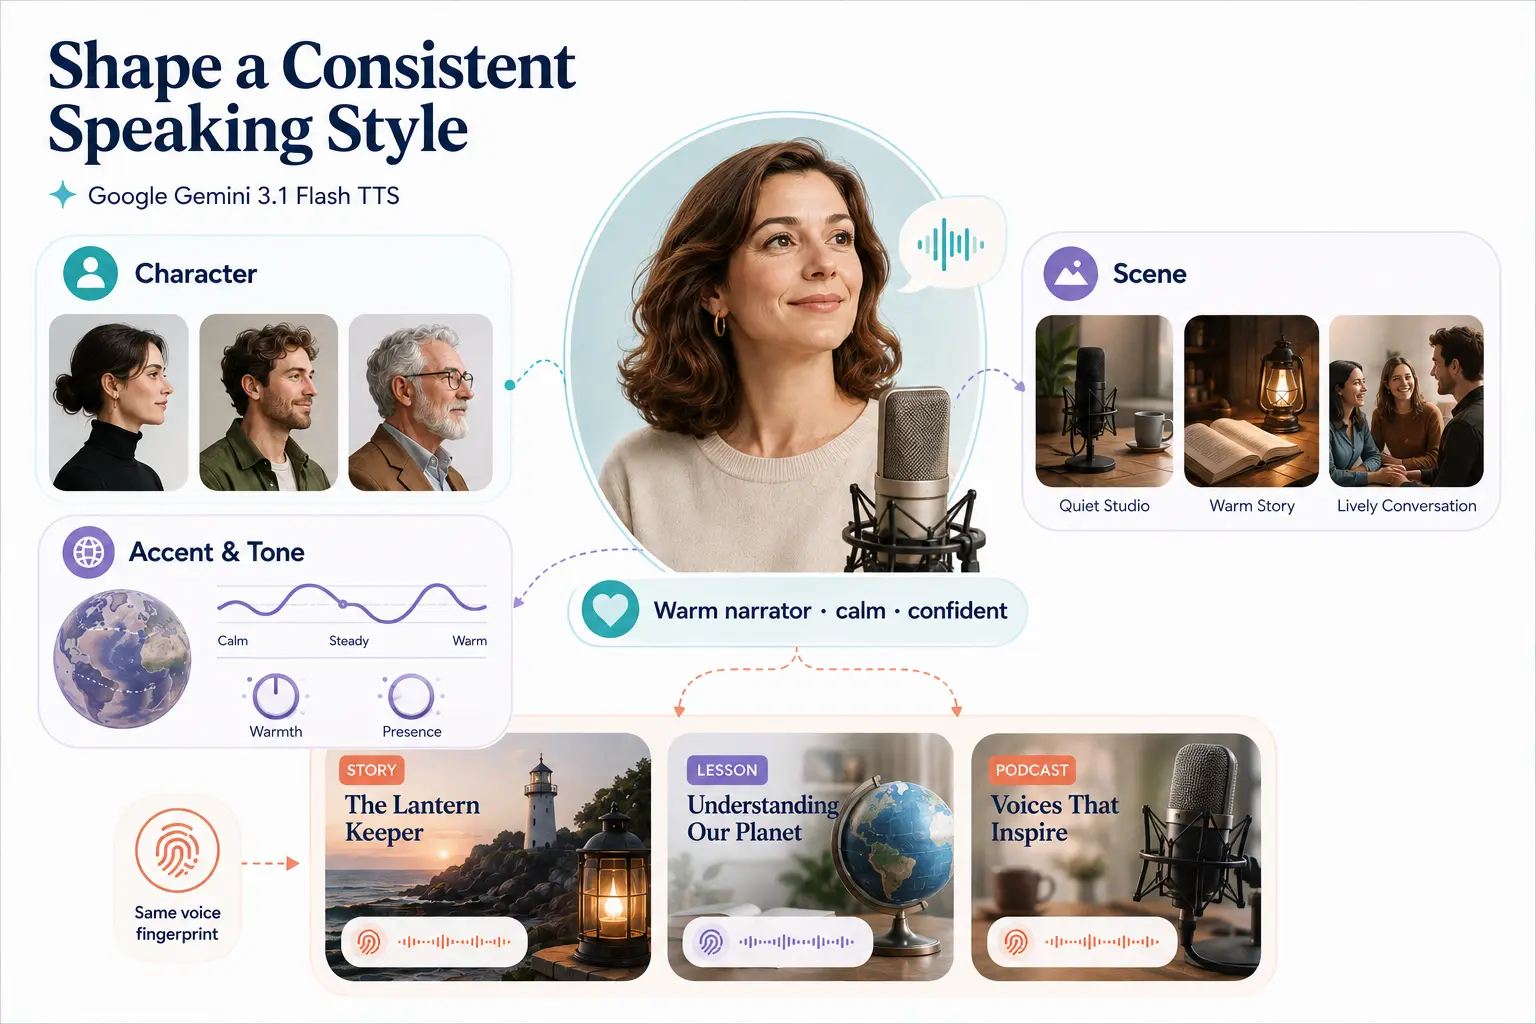
通过 Google Gemini 3.1 Flash TTS API 塑造专属说话风格
自然语言的声音指导让创作者在设计特定说话风格时更加灵活,包括角色身份、场景氛围、口音偏好和整体基调。通过 Google Gemini 3.1 Flash TTS API,这些指令有助于在不同的音频项目中保持一致的声音特征。
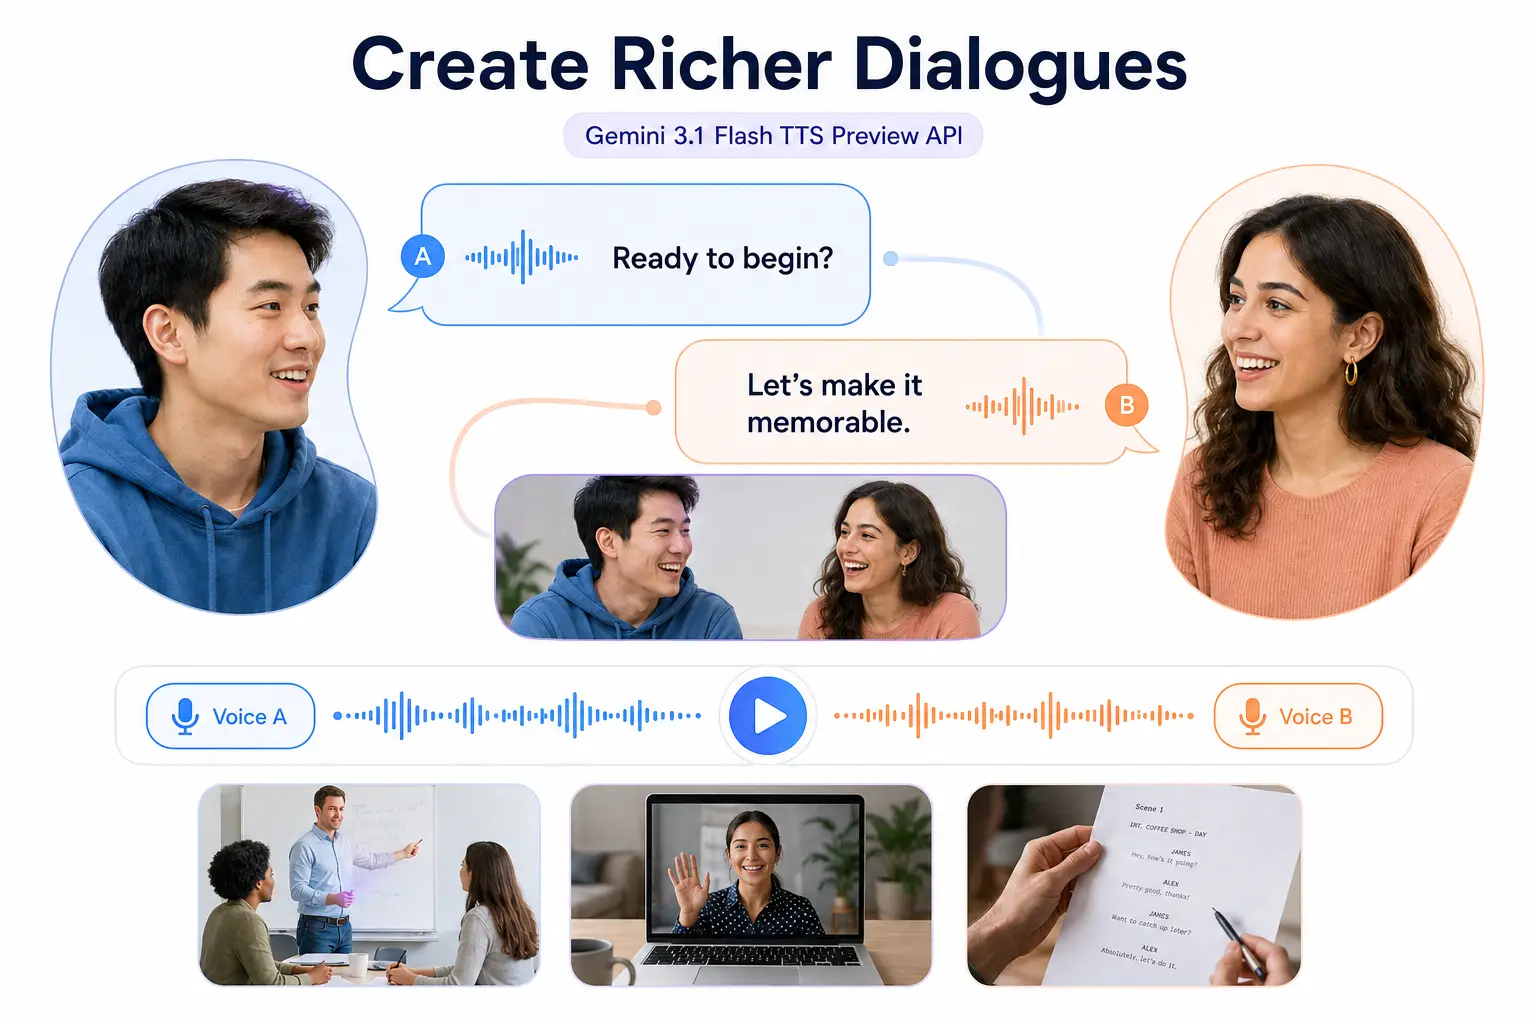
用 Gemini 3.1 Flash TTS Preview API 创作更丰富的对话
多人生成让不同的声音和风格可以在同一段输出中协同,拓展了对话类音频内容的可能性。Gemini 3.1 Flash TTS Preview API 能为虚拟角色、教育材料、剧本讨论和其他互动场景带来更引人入胜的对话。
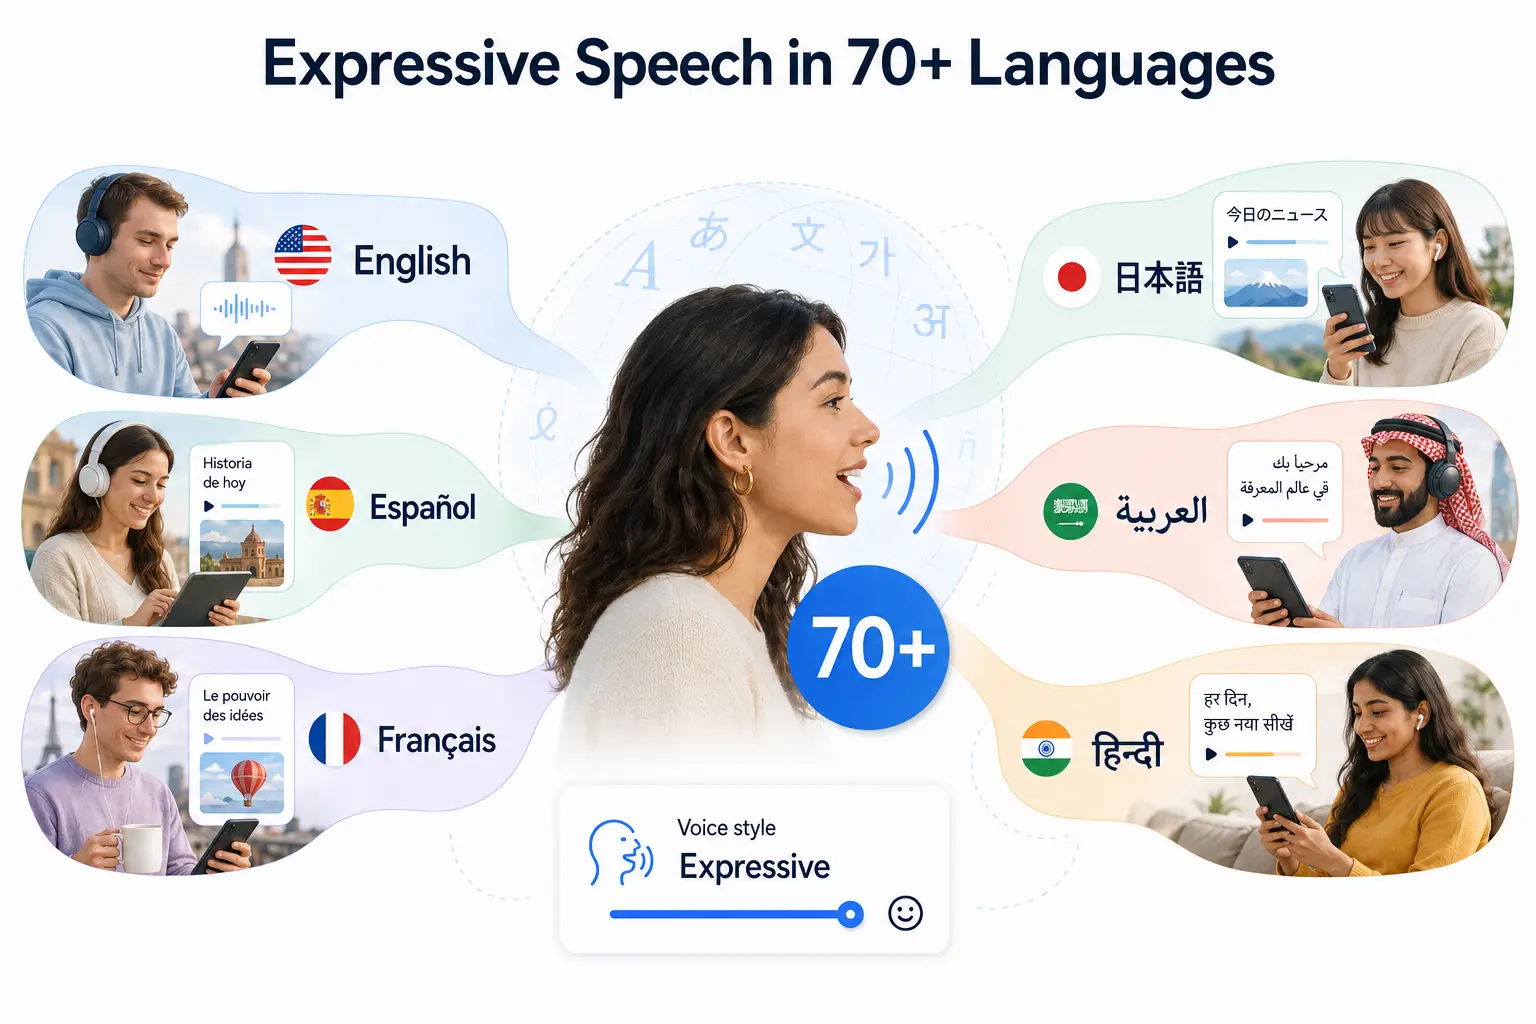
用 Gemini 3.1 Flash 文字转语音 API 提供多语言体验
支持 70 多种语言,开发者可以为不同地区的受众打造本地化的语音体验。Gemini 3.1 Flash 文字转语音 API 把广泛的语言覆盖与富有表现力的声音控制结合起来,让多语言音频生成更自然、更灵活。当前可用的语言、支持的音色和功能更新请查看最新的 ModelFold API 文档。
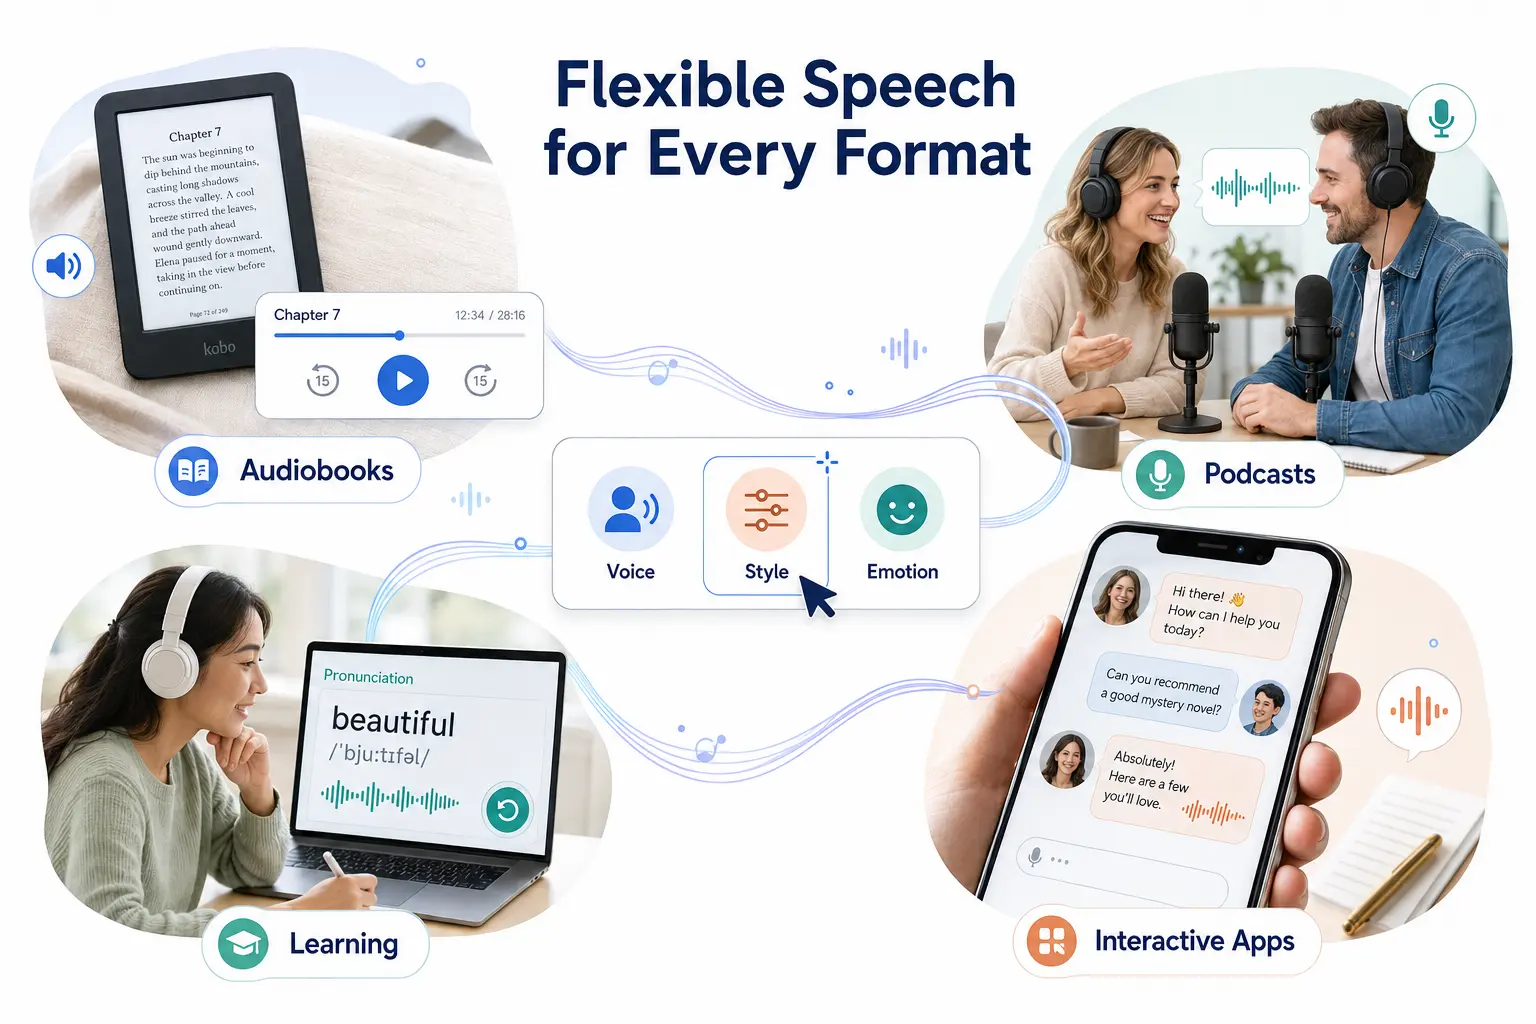
用 gemini-3.1-flash-tts-preview API 构建灵活的语音应用
从有声书、播客到学习平台和互动应用,灵活的语音生成帮助开发者让 AI 声音适应不同的内容形式。gemini-3.1-flash-tts-preview API 让团队在打造定制音频体验时,可以把音色选择、风格指令和表达控制结合起来。
Gemini 3.1 Flash TTS 在主流文字转语音模型中有何突出之处
Gemini 3.1 Flash TTS 着重在高质量语音生成与对表达、语速和声音指导的细致控制之间取得平衡。与其他先进的文字转语音模型相比,它强调自然的对话式表达、多语言语音生成,以及对音频内容演绎方式的灵活控制。下表列出了主要 AI 语音模型之间的关键差异。
| 对比维度 | Gemini 3.1 Flash TTS | Gemini 2.5 Flash TTS | Eleven v3 | Inworld TTS |
|---|---|---|---|---|
| 模型定位 | 富有表现力的语音生成模型,面向自然表达、细致控制和可扩展的多语言音频创作 | 较早的 Gemini TTS 模型,侧重高效、通用的语音合成 | 先进的声音生成模型,侧重高度富有表现力、逼真的语音 | 以角色为中心的语音模型,面向互动式 AI 体验 |
| 语音自然度 | 自然度高,发声更清晰,对话节奏和表达变化更好 | 语音输出自然,但表达控制不够精细 | 声音逼真度高,情绪表现力强 | 自然的角色式声音,针对互动场景优化 |
| 表达控制 | 音频标签和自然语言指令可细致控制情绪、语速、停顿和发声风格 | 支持通用的声音指令,细粒度控制较少 | 通过提示词和声音设计控制声音风格与情绪 | 强调以个性驱动的声音定制 |
| 声音指导 | 支持说话人身份、场景上下文、口音、语气和表演指导 | 提供基础的风格指导 | 支持细致的声音和角色指导 | 围绕打造独特的 AI 角色和个性设计 |
| 多语言能力 | 支持 70 多种语言的多语言语音生成 | 支持多语言输出,但比新一代的限制更多 | 支持跨不同地区的多语言声音生成 | 为对话式应用提供多语言能力 |
| 多人对话 | 支持多位说话人,各有独立的声音特征和表达风格 | 对话生成能力较为有限 | 视工作流支持多声音创作 | 非常注重角色互动和对话场景 |
| 语音定制 | 既支持整体风格指导,也支持逐个时刻的表达调整 | 主要聚焦整体的声音生成设置 | 通过声音设计和风格控制实现强大的定制 | 为互动角色提供强大的定制能力 |
如何用 Gemini 3.1 Flash TTS Preview API 生成富有表现力的语音
只需几个简单步骤即可开始使用……
- 1
1. 创建账号并获取 Gemini 3.1 Flash TTS Preview API Key
先创建 ModelFold 账号,获取用于调用 Gemini 3.1 Flash TTS Preview API 的 API Key。这个 Key 把你的应用和语音生成服务连接起来,让开发者通过统一的 API 流程管理请求。
- 2
2. 配置 Gemini 3.1 Flash TTS Preview API 模型设置
获得访问权限后,选择 Gemini 3.1 Flash TTS Preview API 并配置所需的语音生成设置。开发者可以设定文本输入、音色偏好、语言选项和风格指令,为生成定制音频准备好请求。
- 3
3. 用 Gemini 3.1 Flash TTS Preview API 发送语音生成请求
配置完成后,向 https://ai.modelfold.online/v1/audio/generations 发送 POST 请求,带上 "model": "google/gemini-3-1-flash-tts"、写在 prompt 里的文本(两人对话一行一句写「Speaker 1: …」「Speaker 2: …」)、voice / voice_2,以及可选的 style、scene 和 sample_context。响应直接返回生成好的音频地址。
- 4
4. 用 Gemini 3.1 Flash TTS Preview API 的功能定制声音输出
借助可用的语音控制,开发者可以调整情绪、停顿、说话风格和角色指导等表达元素来精修生成的音频。这些定制选项有助于打造更自然的旁白、对话和互动语音体验。
- ✓
5. 把生成的音频集成到你的应用
收到生成的音频后,开发者可以把它集成到各种产品中,包括语音助手、有声书、播客、教育平台和无障碍方案。当前的 API 参数、支持的功能和集成更新请查看最新的 ModelFold API 文档。
gemini-3.1-flash-tts-preview API 提示词指南:让语音更有表现力
参考这些实用技巧,充分发挥平台的能力。
在 Gemini 3.1 Flash TTS API 中让指令与文本保持一致
当期望的说话风格与内容本身相符时,效果通常最好。如果提示词要求紧迫、兴奋或紧张感,文本本身也应体现这种情绪,这样生成的音频听起来才更可信、更一致。
在 Gemini 3.1 Flash TTS API 中给自然表达留出空间
过度控制每个细节会让输出不够流畅。清晰的整体指导往往比强行规定每个词、每处停顿和每次情绪转换效果更好,因为 Gemini 3.1 Flash TTS 能自然地补足一部分表演细节。
为 Google Gemini 3.1 Flash TTS API 写生动、易朗读的文本
措辞越有表现力,声音可发挥的空间就越大。带有情绪、张力、惊喜、温暖或个性的句子,通常比平淡或过于笼统的表述生成更吸引人的音频,在旁白、对话和故事讲述场景中尤其如此。
在 Gemini 3.1 Flash TTS Preview API 中用音频标签处理特定时刻
提示词适合塑造整体说话风格,音频标签则更适合控制单个时刻。这样可以更容易地在剧本中最关键的位置加入停顿、柔化一句话、转换情绪,或制造更强烈的声音反应。
在 Gemini 3.1 Flash 文字转语音 API 中用标点改善节奏
逗号、句号等标点有助于塑造语音的自然流动。结构良好的句子通常能带来更顺畅的换气、更清晰的断句和更好的节奏,这对长篇音频和讲解类内容尤其有帮助。
用 gemini-3.1-flash-tts-preview API 逐步测试和打磨表达
提示词的小调整就能让最终声音输出产生明显变化。与其一次全部重写,开发者可以逐步打磨风格指令、情绪措辞和标签位置,得到更自然、更可控的结果。当前支持的功能、音色和提示词相关选项请查看最新的 ModelFold API 文档。
Gemini 3.1 Flash TTS API 让 AI 语音活起来的场景
用 Gemini 3.1 Flash TTS API 打造富有表现力的有声书和故事旁白
有声书平台和故事类应用可以用 Gemini 3.1 Flash TTS API 把书面故事变成节奏更自然、情绪更丰富的旁白。把声音指导和语音控制结合起来,开发者可以打造角色风格鲜明、过渡更流畅、故事更引人入胜的沉浸式收听体验。
由 Gemini 3.1 Flash TTS API 驱动的互动语音助手
语音助手和对话式应用可以借助 Gemini 3.1 Flash TTS API 为用户生成更自然的语音回复。可调整的语气、节奏和表达风格,让客服、虚拟助手和 AI 应用中的语音交互更具适应性。
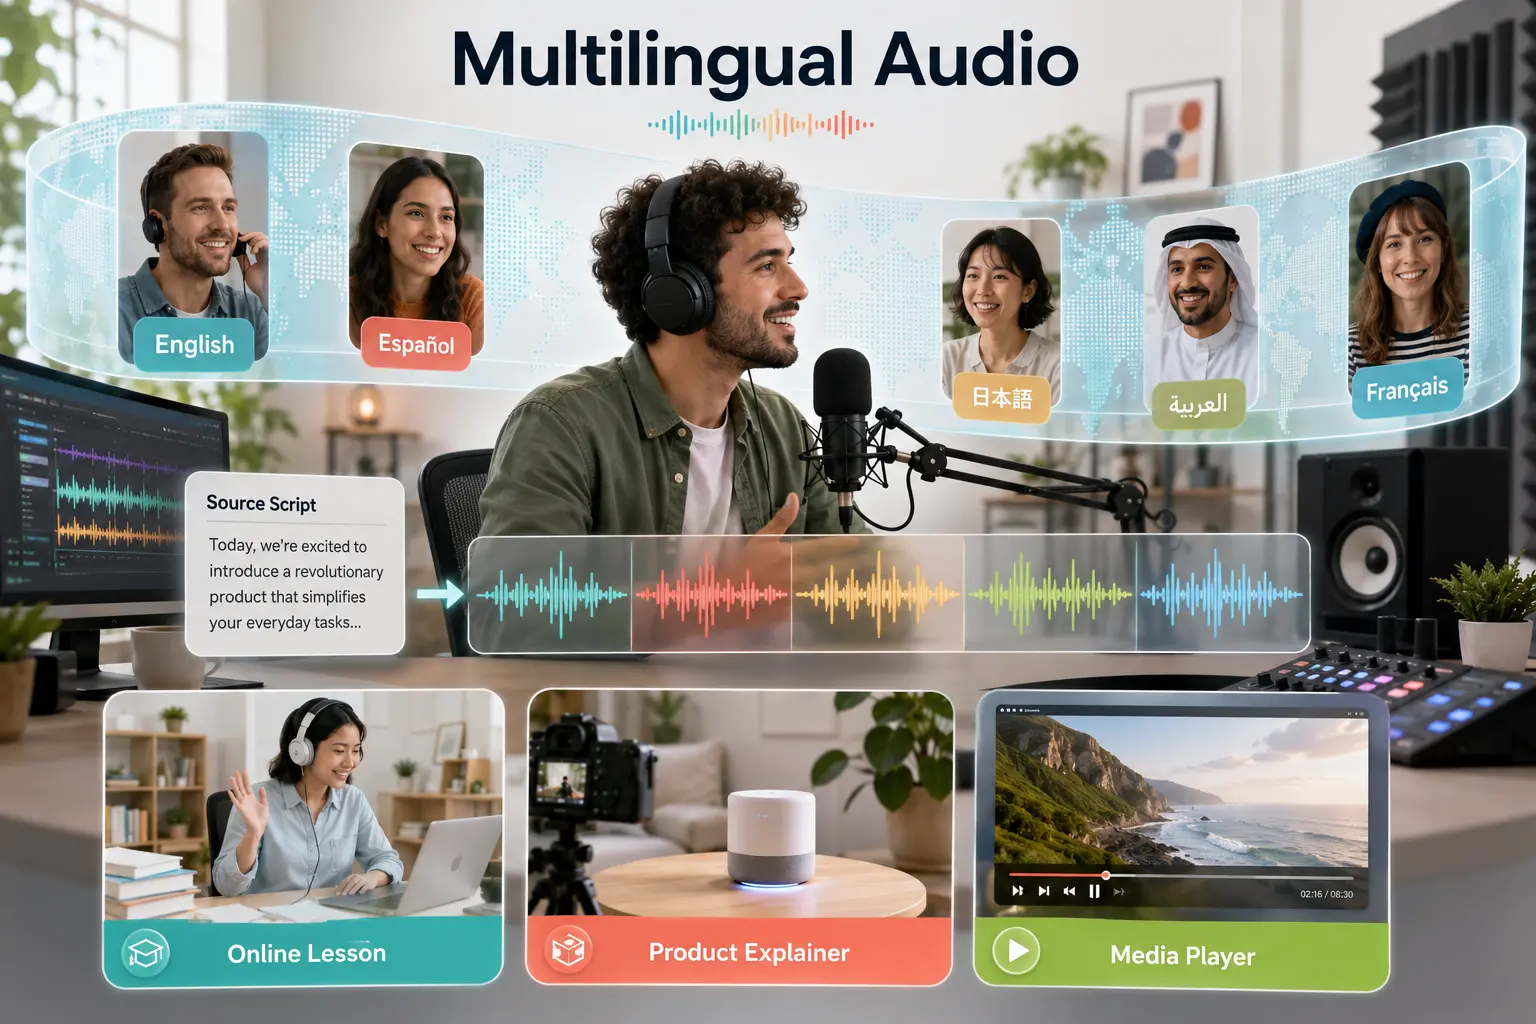
用 Gemini 3.1 Flash TTS Preview API 创作多语言内容
面向全球受众的内容平台可以用 Gemini 3.1 Flash TTS Preview API 生成不同语言的本地化音频体验。借助 70 多种语言支持和灵活的声音控制,开发者可以制作多语言课程、媒体内容、产品讲解和区域化音频材料。
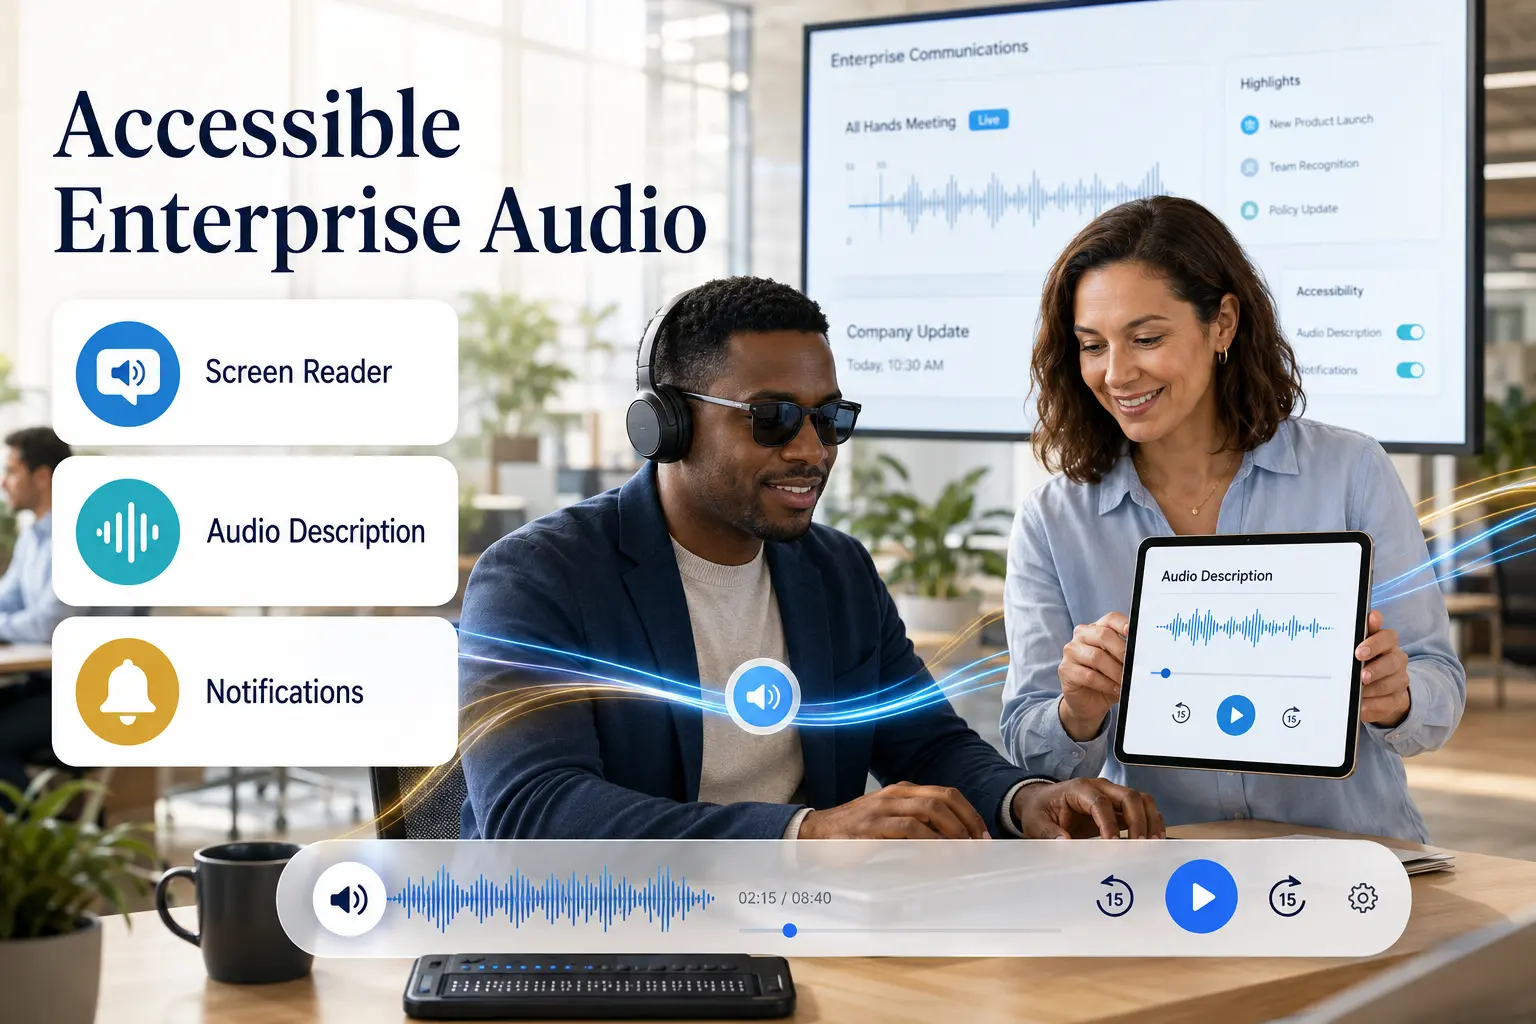
用 Gemini 3.1 Flash TTS Preview API 打造无障碍和企业音频方案
无障碍产品和商业应用可以用 Gemini 3.1 Flash TTS Preview API 提供清晰、富有表现力的语音输出。从屏幕阅读器、音频描述到自动通知和客户沟通系统,生成的声音都可以按不同的信息传达需求进行调整。
为什么在 ModelFold 上选择 Google Gemini 3.1 Flash TTS API
高性价比的 Gemini 3.1 Flash TTS API 价格
ModelFold 为开发者提供了更易上手的 Gemini 3.1 Flash TTS API 使用方式,同时保留各类应用所需的核心语音生成能力。灵活的定价让你更容易在不同用量需求的项目中测试、扩展和集成 AI 语音功能。
简单集成 Gemini 3.1 Flash TTS API
精简的集成流程帮助开发者更高效地把 Gemini 3.1 Flash TTS API 接入应用。API 访问清晰、请求处理直接、开发流程有序,团队可以专注于打造语音体验,而不是处理复杂的配置。
完整的 Gemini 3.1 Flash TTS API 文档
详细的文档帮助开发者在使用 Gemini 3.1 Flash TTS API 时了解可用功能、请求结构、支持的选项和集成流程。清晰的指引让你更容易探索声音生成能力,并为不同的应用场景落地语音方案。
ModelFold 提供多种 AI 语音模型
ModelFold 提供多种 AI 模型,开发者可以探索不同的语音生成选项,按质量、速度和应用需求选择合适的方案。这种灵活性帮助团队比较各模型能力,用合适的模型搭建音频工作流。
Gemini 3.1 Flash TTS API 集成获得可靠支持
技术支持帮助开发者解决集成问题、排查故障、改进语音生成工作流。无论是测试新应用还是部署生产项目,整个开发过程中都能获得协助。
用 Gemini 3.1 Flash TTS API 构建可扩展的音频应用
从内容创作平台到语音助手和无障碍工具,Gemini 3.1 Flash TTS API 能支撑各种 AI 音频应用。ModelFold 为开发者提供了一个尝试富有表现力的语音生成、高效扩展音频项目的环境。
Gemini 3.1 Flash TTS API 常见问题
Gemini 3.1 Flash TTS API 是什么?⌄
Gemini 3.1 Flash TTS API 是一个文字转语音模型,能把书面内容转换成自然、富有表现力的音频。它支持通过风格指令和音频标签精细控制声音,开发者可以针对不同的语音生成场景调整语气、语速、情绪和表达风格。
Gemini 3.1 Flash TTS 和 Gemini 2.5 Flash TTS 有什么不同?⌄
与 Gemini 2.5 Flash TTS 相比,Gemini 3.1 Flash TTS 的语音质量更好,能通过音频标签和自然语言指导更细致地控制表达,支持 70 多种语言,多人对话的声音指导也更灵活。
Gemini 3.1 Flash TTS 中的音频标签是怎么用的?⌄
音频标签让开发者在文本中加入表达指令,引导语音输出的特定部分。它们可以控制情绪、停顿、耳语、笑声和语速变化等元素,让旁白、对话和互动应用中生成的音频更生动、更自然。
Gemini 3.1 Flash TTS 能生成多位说话人吗?⌄
能。Gemini 3.1 Flash TTS 支持多人对话生成,每位说话人有不同的声音特征和表达风格。开发者可以借此打造更自然的对话、角色互动、教学对话和有鲜明说话人身份的剧本音频。支持的多人配置、可用选项和集成细节请查看最新的 ModelFold API 文档。
哪些类型的应用可以使用 Gemini 3.1 Flash TTS API?⌄
Gemini 3.1 Flash TTS API 能支撑各类语音应用,包括有声书、播客、语音助手、无障碍工具、教育平台、本地化内容和自动化商务沟通。富有表现力的控制和多语言能力,让它适合需要更吸引人的 AI 声音的项目。
可以通过 ModelFold 使用 Gemini 3.1 Flash TTS API 吗?⌄
可以。开发者可以通过 ModelFold 使用 Gemini 3.1 Flash TTS API,把富有表现力的 AI 语音生成集成到应用中。ModelFold 提供了精简的方式连接模型、构建语音工作流,无需管理多套独立集成。
在哪里可以找到 Gemini 3.1 Flash TTS API 文档?⌄
ModelFold 上最新的 Gemini 3.1 Flash TTS API 文档介绍了集成方法、支持的选项、可用能力和使用要求。开发者应查阅文档了解最新的模型功能和 API 细节。
| Gemini 3 1 Flash Tts | 每 1000 字 9 积分 · 最低 8 |
任务开始时按估价预扣,完成后按上游实际消耗结算,多退少补,不低于最低价。
curl https://ai.modelfold.online/v1/audio/generations \
  -H "Authorization: Bearer $MODELFOLD_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"google/gemini-3-1-flash-tts","prompt":"Speaker 1: Hello!\nSpeaker 2: Hi there.","voice":"Zephyr"}'